金发〔2026〕8 号解读:个人信息不得入模训练,语料入库门禁怎么建
本文原载于微信公众号,原题《金融机构高质量数据集建设:个人信息不得入模训练,进入数据集先过一道「门禁」》。
副标题:模型效果可以慢慢调,一条身份证号进了训练集,就再也撤不回来。
6 月 18 日,金融监管总局印发《关于银行业保险业人工智能安全开发应用的指导意见》(金发〔2026〕8 号)。32 条意见里,分量最重的一条在第二十四条:姓名、身份证号、手机号、银行卡号等个人信息和隐私数据,不得用于生成式人工智能模型的训练和优化。
条文用的是“不得”两个字,前面没有“审慎”“原则上”这类缓冲词,没留余地。
这条禁令落在了金融机构最不设防的地方。眼下各家机构都在建高质量数据集,语料多半来自存量文档和业务数据:客服工单里有手机号,投顾记录里有客户姓名,理赔材料里有证件号。哪些文件里藏着这些东西,多数机构自己也说不全。一旦混进训练集,模型记住了,就没有撤回的办法。
这篇文章讲一个具体做法:在语料进加工流程之前设一道门禁,让这条红线由系统来执行。
一、监管这次把要求写到了“数据”这一层
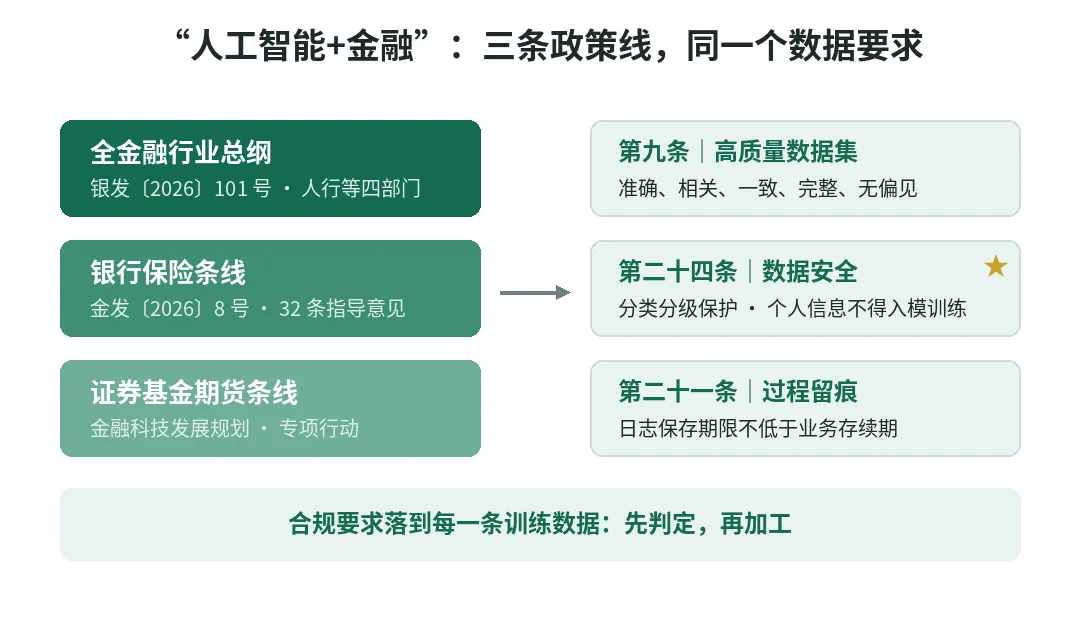
先把政策的层次理清楚。人民银行、国家发改委、金融监管总局、证监会四部门今年联合印发了《关于“人工智能+金融”的实施意见》(银发〔2026〕101 号),这是全金融行业的总纲;银行保险条线,金发 8 号文给出 32 条细则;证券基金期货条线,证监会的《资本市场金融科技发展规划(2026—2030 年)》和“人工智能+”专项行动在推同样的事。三条线出自三个部门,对数据安全的要求指向同一处。
具体到金发 8 号文,与数据直接相关的有三条。
第九条讲高质量数据集:确立数据质量标准,确保数据的准确性、相关性、一致性、完整性和无偏见。
第二十四条讲数据安全:将人工智能数据安全纳入企业数据安全管理体系,严格落实数据分类分级保护要求,完善数据脱敏规范,随后就是开头那条个人信息禁令。
第二十一条讲留痕:加强模型开发和训练过程记录,日志保存期限不低于业务存续期。
三条放在一起读,意思很清楚:合规要求已经落到每一条训练数据上,数据先判定、再加工,顺序不能反。
二、真做起来,会卡在四个地方
这些要求没有机构会反对,难的是执行。
头一个障碍是数据形态。语料的大头是非结构化数据——办公过程中产生的 Word、PDF、Excel、邮件、会议纪要、工单记录。这部分数据量最大、敏感信息最密,却长期游离在数据治理之外:没有表结构,散落在共享目录和个人盘里,谁都知道里面有东西,谁都不愿意去碰,一拖就是很多年。金发 8 号文第八条这次专门点了名,要求加强对非结构化数据的管理,制定采集、清洗、标注、应用、退出的管理规范。
落到数据集建设的现场,问题通常卡在四个地方。
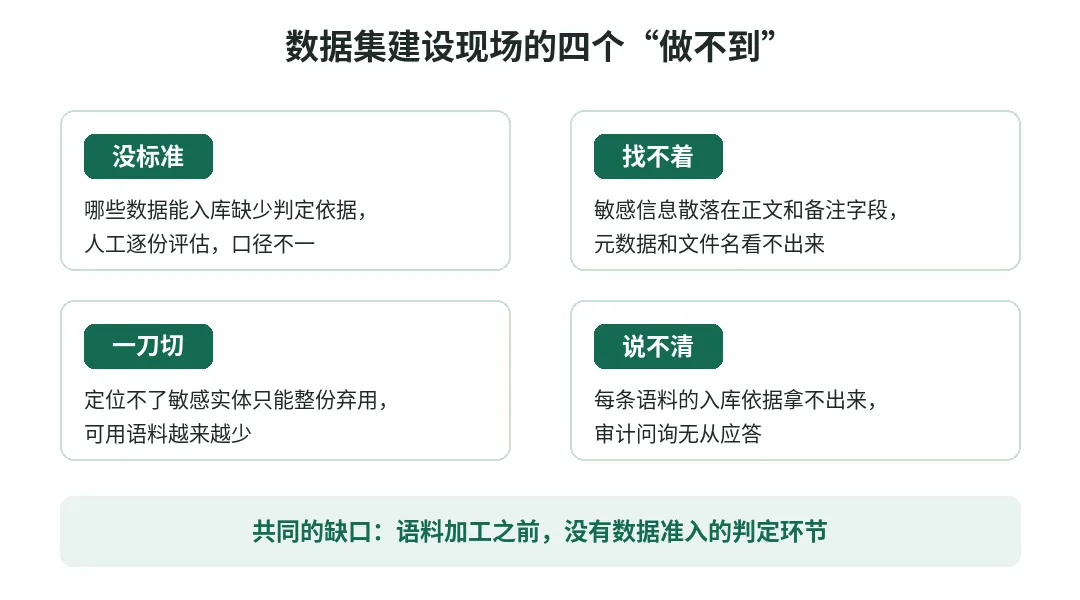
没标准。哪些数据可以进语料库,缺少可执行的判定依据,只能靠人工逐份评估,效率低,口径还不一致。
找不着。敏感信息藏在文档正文和备注类字段里,看元数据、看文件名都发现不了。银行的客户档案、保险的理赔记录、券商的投顾工单、互金平台的客服日志,都是这个形态。
一刀切。定位不了文件里的敏感实体,含敏感信息的文件就只能整份弃用。语料越洗越少,数据集的质量反而受损。
说不清。审计问询或数据集对外流通时,拿不出每条语料的入库依据和处理记录。第二十一条要求日志保存不低于业务存续期,前提是——得先有日志。
四个问题指向同一个缺口:语料加工流程的前面,缺一个数据准入的判定环节。
三、做法:在语料加工前面加一道门禁
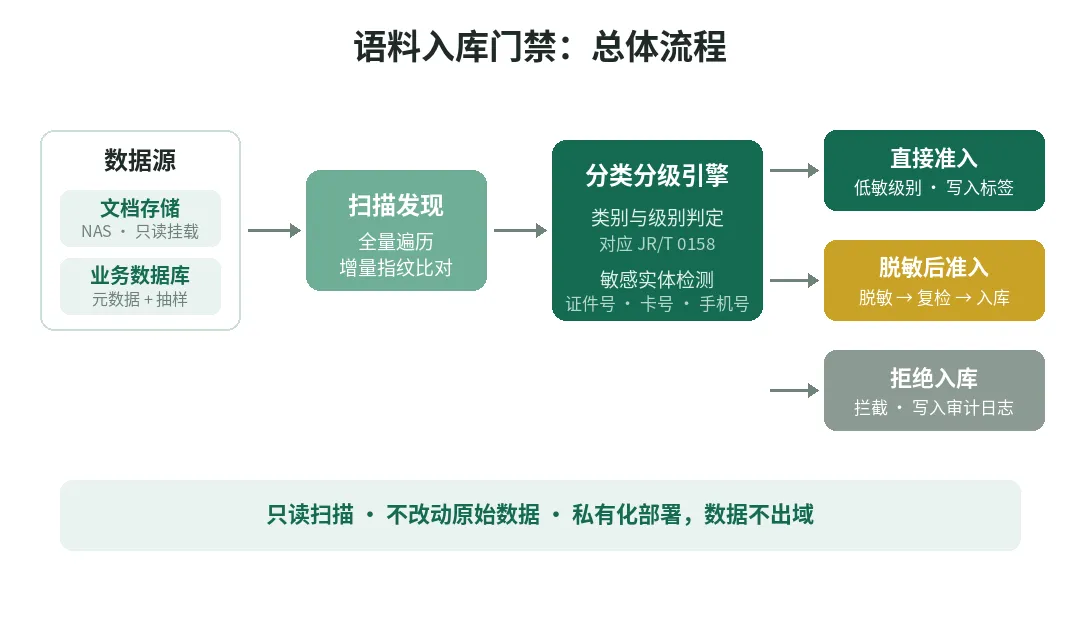
补上这个环节的做法并不复杂:拟入库的数据先扫描、先判定,再决定放行还是拦截。
扫描发现服务以只读方式接入文档存储和业务数据库,AiDClass 分类分级引擎对每份数据做两件事:按 JR/T 0158、0197 等行业标准给出类别和级别,同时检测内容中的敏感实体。判定结果对应三个出口——
| 出口 | 判定条件(对应分类分级结果) | 处理动作 | 典型数据 |
|---|---|---|---|
| 直接准入 | 级别为低敏(1–2 级),未检出敏感实体 | 写入标签后生成 JSON 语料 | 已公开研报、公告、产品说明 |
| 脱敏后准入 | 级别为中敏(3 级),检出可脱敏实体(证件号、账号、联系方式等) | 输出实体清单,脱敏复检达标后入库 | 客服工单、投顾与理赔服务记录 |
| 拒绝入库 | 级别为高敏(4 级),或属于约定的禁入类别 | 拦截、写入审计日志、通知数据管理员 | 客户身份档案、未公开重要信息 |
表 1 门禁三出口判定标准(判定矩阵经合规部门评审后固化执行)
三个出口的判定条件直接对接分类分级结果。第二十四条要求“严格落实数据分类分级保护要求”,落的就是这个点:
分类分级的结果直接决定一份数据能不能入库——台账上的级别,第一次有了执行力。
判定矩阵由合规部门评审确认后固化成规则版本,系统统一执行。人从逐份评估里解放出来,管标准、审例外。
这道门禁的功夫,重点下在非结构化数据上。数据库表有结构、有字段注释,处理路径是现成的:按字段级打标,导出时整列放行、脱敏或剔除。办公文档没有任何结构可依,AiDClass 引擎直接解析 doc、docx、pdf、xls、ppt、txt 等常见办公格式,支持压缩包展开,正文、表格、批注一并识别。结构化数据照常处理,真正难啃的那批存量文档,恰恰是这套引擎的主场。
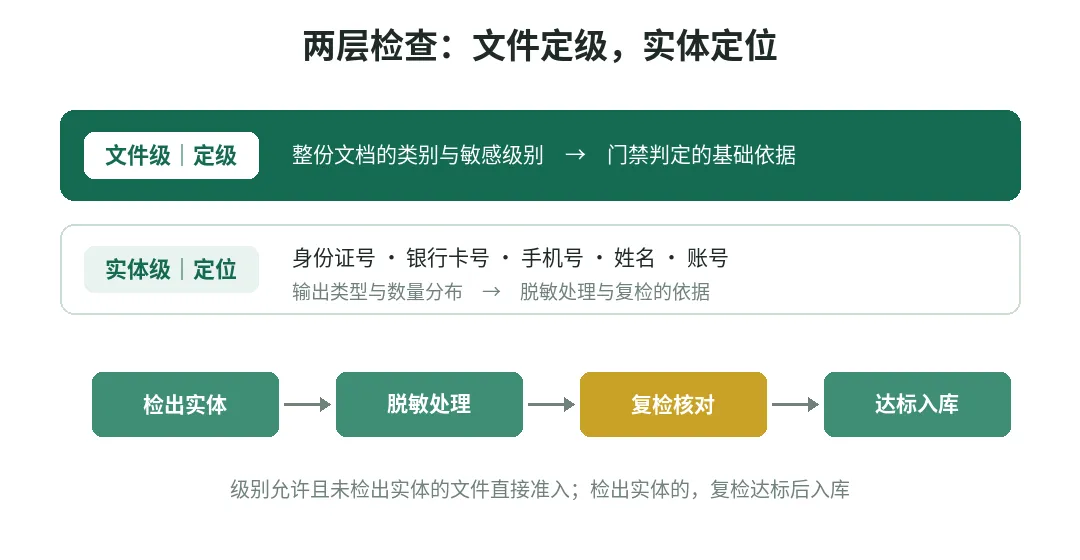
四、两层检查:文件定级,实体定位
门禁能不能守住“个人信息不得入模”这条线,取决于检查做到多细。方案设计了两层。
文件级检查,对整份文档给出类别和敏感级别,作为门禁判定的基础依据。级别允许、又未检出敏感实体的文件,直接准入。
实体级检查,把内容里的身份证号、银行卡号、手机号、姓名、账号一个个找出来,输出类型与数量分布。这份清单有两个用途:交给脱敏环节作处理依据;脱敏之后复检,核对每个实体是否已处理干净,达标才放行入库。
入库前把敏感实体找出来,脱敏之后再复检一遍,“个人信息不得用于训练”才算真正落了地。
“一刀切”的问题也在这一层得到解决:能定位实体,就能精确脱敏,一大批原本只能整份弃用的文档,处理后重新变成可用语料。
五、标签跟着语料走,审计问得清
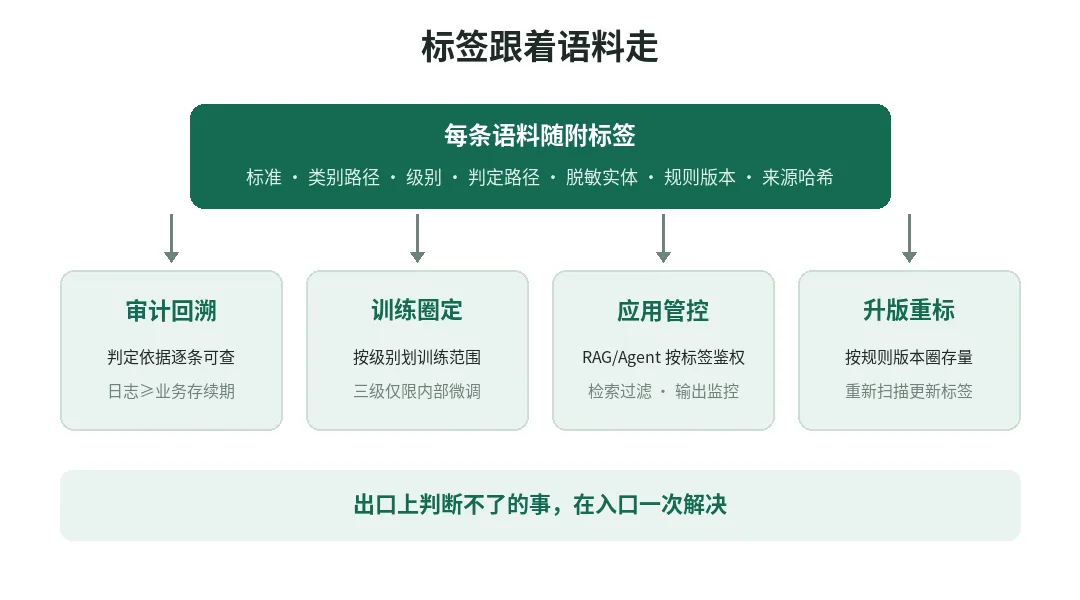
通过门禁的语料,在生成 JSON 时同步写入一组标签:依据的标准、类别路径、敏感级别、判定路径、脱敏过的实体、规则与引擎版本,以及来源路径和文件哈希。
| { “corpus_id”: “doc_20260702_000183”, “content”: ”…(脱敏后文本)…”, “label”: { “standard”: “JR/T 0158-2018”, “category_path”: “客户/身份信息/联系方式”, “sensitivity_level”: 3, “gate_decision”: “masked_admit”, “masked_entities”: [“mobile”, “id_card”], “rule_version”: “v2.3”, “engine_version”: “aidclass-2.4” }, “provenance”: { “source_path”: “//nas01/…/xxx.docx”, “file_hash”: “sha256:…” } } |
|---|
入库语料的标签结构(示例)
这组标签有四个用处。
审计回溯。每条语料都带着判定依据和规则版本,监管问询时逐条可查——第二十一条“日志保存不低于业务存续期”、第二十二条“责任可追溯”,落点都在这里。
训练圈定。训练集划分可以按标签圈范围,比如三级语料只用于内部微调,不进对外服务的检索库。
应用管控。银行的实际业务里,AI 应用远不止训练这一件事:知识库问答、RAG 检索、智能体调用,个人信息在这些场景同样是红线,进不得知识库;内部经营管理数据、业务指标这类敏感内容,也要分人分角色控制访问。难点在出口——内容被模型揉进回答之后,输出端几乎判断不了它来自几级数据。标签在入库时打好,检索就能按级别过滤,Agent 就能按角色鉴权,监控审计也有了落点。
AI 输出端难以判断的事,在数据入口一次解决:入库时打好类别与级别,RAG 和智能体的权限管理、监控管控才有依据。
升版重标。行标或内部制度更新后,按规则版本圈出受影响的存量语料,重新扫描、更新标签,不必推倒重来。
六、这道门禁换来什么
最后算一笔账,这道门禁给金融机构换来三样东西。
合规上,“个人信息不得入模”由制度要求变成系统里的一条规则,每条语料有判定、有记录、有出处,监管问到哪条都答得上。
效率上,扫描判定替代人工逐份评估,增量数据按文件指纹识别、按时间窗口例行处理;“脱敏后准入”留出了中间地带,可用语料不再因一刀切流失。
资产上,带标签的语料库本身就是指导意见第九条鼓励的高质量数据集——质量有标准、来源可追溯、用途可管理,也为第十条提出的行业数据集共建共享预留了接口。那批多年没人敢碰的办公文档,也第一次盘点清楚,变成了可以放心使用的资产。
落地前提只有一句话:只读扫描、不改动原始数据,引擎、规则与日志全部私有化部署,数据不出域。
结语
监管把红线画在了数据上,防线就应该建在数据的入口。
分类分级是 AI 数据安全的地基——先让每条数据说清楚自己是谁、几级、能不能进,高质量数据集才立得住,金融 AI 应用才走得远。
参考资料
[1] 国家金融监督管理总局:《关于银行业保险业人工智能安全开发应用的指导意见》(金发〔2026〕8 号),2026 年 6 月 18 日
[2] 中国人民银行、国家发展改革委、金融监管总局、中国证监会:《关于“人工智能+金融”的实施意见》(银发〔2026〕101 号)
[3] 国务院:《关于深入实施“人工智能+”行动的意见》(国发〔2025〕11 号)
[4] 中国证监会:《资本市场金融科技发展规划(2026—2030 年)》,2026 年 3 月
[5] JR/T 0158—2018《证券期货业数据分类分级指引》
[6] 《中华人民共和国数据安全法》《中华人民共和国个人信息保护法》
说明:银发〔2026〕101 号文全文未见公开,本文仅引用文件名与文号(据粤金管〔2026〕13 号文转引);具体条款解读均以金发〔2026〕8 号公开全文为依据。
—— 模界数智 · AiDClass 团队
相关解决方案
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流