Cyera Omni DLP 拆解:分类分级如何变成会自我进化的 DLP 策略
从「知」到「行」,分类分级如何变成动态生成、自我进化的 DLP 策略
模界数智 · AiDClass 团队 | 海外数据安全观察 | 本系列承接上篇《五个人、五个月、5000万美元》
上一篇我们拆了 Cyera 两年五购、条条指向 DLP 的那串收购清单,结论落在一句话上——它买的不是拦截的肌肉,而是把大脑接上肌肉的速度。但大脑不能只是个说法。它得真的指挥拦截动作:在一份文件流出之前,判断这是什么数据、对这家机构意味着什么、该不该拦、怎么拦。
最近 SACR(Software Analyst Cyber Research)出了一份深度报告,正好把「大脑怎么指挥肌肉」这件事讲清楚了。需要先说明:这份报告由 Cyera 提供支持,里面的降噪比例、误报数字都是厂商口径,没有第三方验证——所以我们看它的方法论,不照搬它的营销数。把机制拆开,你会发现它讲的那套东西,和我们做 AiDClass 在做的,是同一件事。
一、老 DLP 的病,到底病在哪
DLP(数据防泄漏)是个三十多年的老品类,也是企业安全里被抱怨最多的之一。报告给了三组挺扎心的数字。
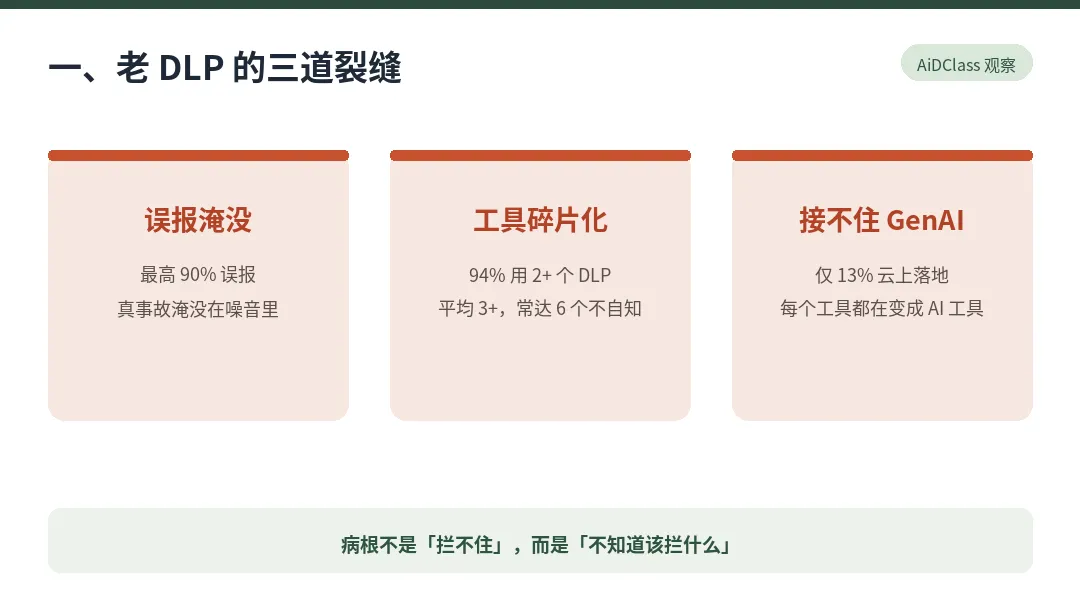
第一组:传统 DLP 的误报率最高能到 90%。安全团队一天收上千条告警,九成是噪音,真正的事故反而淹在里面。第二组:94% 的企业用了至少两个 DLP,平均三个以上,很多组织装了六个还不完全清楚自己装了哪些——工具越堆越多,盲区却没变小。第三组:83% 的企业用端点 DLP,但只有 13% 真正在云上把数据安全能力落地(Forrester,2024 年 7 月)。看得见的地方拼命设防,数据真正流动的地方却几乎裸奔。
病根上一篇说过,这里再点一次:不是拦不住,是不知道该拦什么。传统 DLP 靠正则表达式和关键词识别敏感内容,规则脆弱——调严了挡正常业务、惹恼全公司;调松了形同虚设。三十年就在这两端之间来回摇摆。
生成式 AI 又把泄漏面彻底撕开了。员工把源代码、客户名单、财务模型直接粘进浏览器里的 AI 对话框;而 AI 已经不是几个能单独圈起来保护的「AI 工具」——连 Zoom 都内嵌了 AI。报告里有句话很到位:你没法只保护 AI 工具,因为每一个工具都在变成 AI 工具。数据不再需要「穿过出口」才算泄漏,它在一次对话里就完成了转移。
二、新解法不是「再造一个更大的网关」,而是「加一层大脑」
面对这些裂缝,Cyera 的 Omni DLP 给的解法,反常识的地方在于:它不打算替换你现有的 DLP。
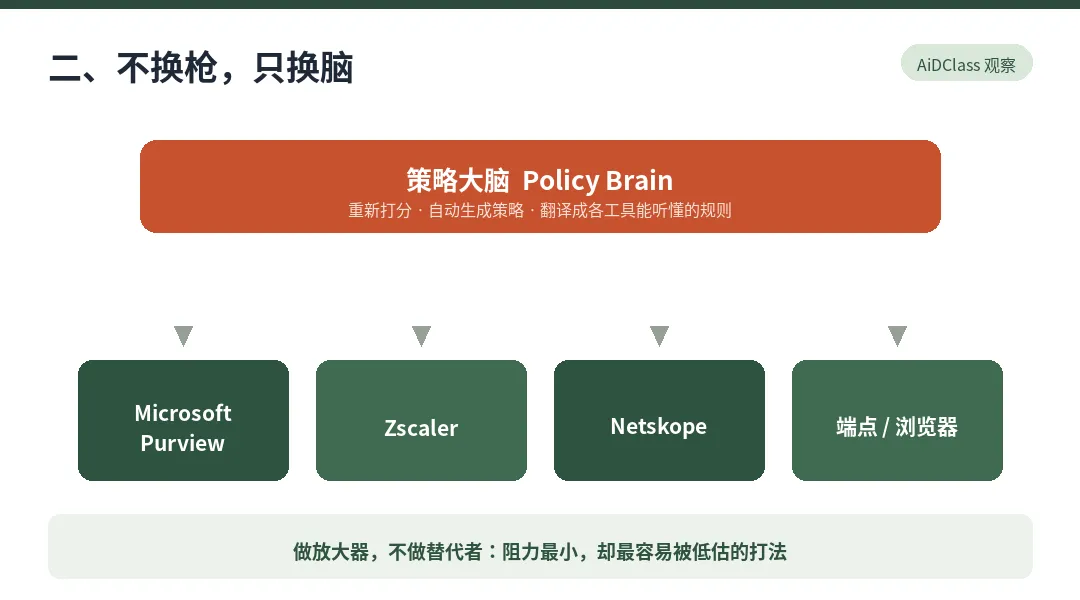
报告反复强调一句话——not a rip-and-replace, but an intelligence layer:不是推倒重来,而是加一层智能。Omni DLP 把自己定位成一个「策略大脑(policy brain)」,坐在客户已经买好、已经在跑的执行工具之上——Microsoft Purview、Zscaler、Netskope 这些不动,通过 API 接进去,对每一个数据流动事件重新打分,再把更聪明的判断下发回这些工具去执行。一句话:不换枪,只换脑,把你手里的存量许可证变聪明。
这个姿态本身就值得国内同行琢磨。在一个三十年的成熟市场里,做「替代者」的销售阻力极大——客户的旧系统深度耦合、迁移成本高、责任人怕担风险。而做「放大器」几乎没有抵抗:我不让你换掉什么,我只让你已经有的东西变好用。这是 AI 切入成熟品类时,一种阻力最小、却最容易被低估的打法。
三、大脑是怎么指挥肌肉的——拆解 Omni DLP 的四步动作
这是全文的核心。把 Omni DLP 运转起来,其实是一个闭环的四步,每一步都踩在「分类」这块底座上。
第一步,喂上下文。 Omni DLP 吃进来的不是泛泛的「信用卡号」正则,而是 Cyera 自家 DSPM 产出的「数据 DNA」——精确到字段、列级别的分类结果,再叠加身份上下文(从 AD、HRIS 拉来的人员信息)。也就是说,系统在判断之前,先知道「这份数据是什么、属于谁、谁在动它」。报告里有个关键数字:在一个客户环境里,大约 20%–40% 的分类类别是这家企业独有的、靠 GenAI 现学出来的——通用规则覆盖不到这部分,而它往往正是最敏感的核心数据。
第二步,重新打分。 数据流过 email、web、SaaS、端点,以及 Copilot、ChatGPT 这些 AI 通道时,大脑对每个事件实时重新评估风险。它背后的大语言模型会读完整的载荷——包括发给 LLM 的 prompt 和返回的响应——并且用大白话解释「为什么拦这一条」。这点很重要:传统 DLP 拦了你也不知道为什么,而能讲清理由,才谈得上让业务方信任。
第三步,自动写策略。 这是最见功力的一步。AI 学会了这家企业独有的敏感数据长什么样之后,自动生成检测规则,再把规则翻译成每个执行工具能听懂的策略语言下发过去——Purview 听 Purview 的话,Zscaler 听 Zscaler 的话。安全团队几乎不用再手写正则。报告把这层关系说得很直白:DSPM 提供「基线逻辑」,DLP 引擎用这套逻辑生成准确的检测规则,人工介入降到最低。
第四步,自我进化。 每一条告警都回流进模型:分析师标注、模型校准,误报往下走、召回往上走;系统还用 A/B 测试持续调优策略。Cyera 宣称这套闭环能把噪音压低 95%(再提醒一次,厂商口径)。重点不在那个数字,而在于——DLP 第一次从「人工调规则的苦役」变成了「会自己学习的活体」。
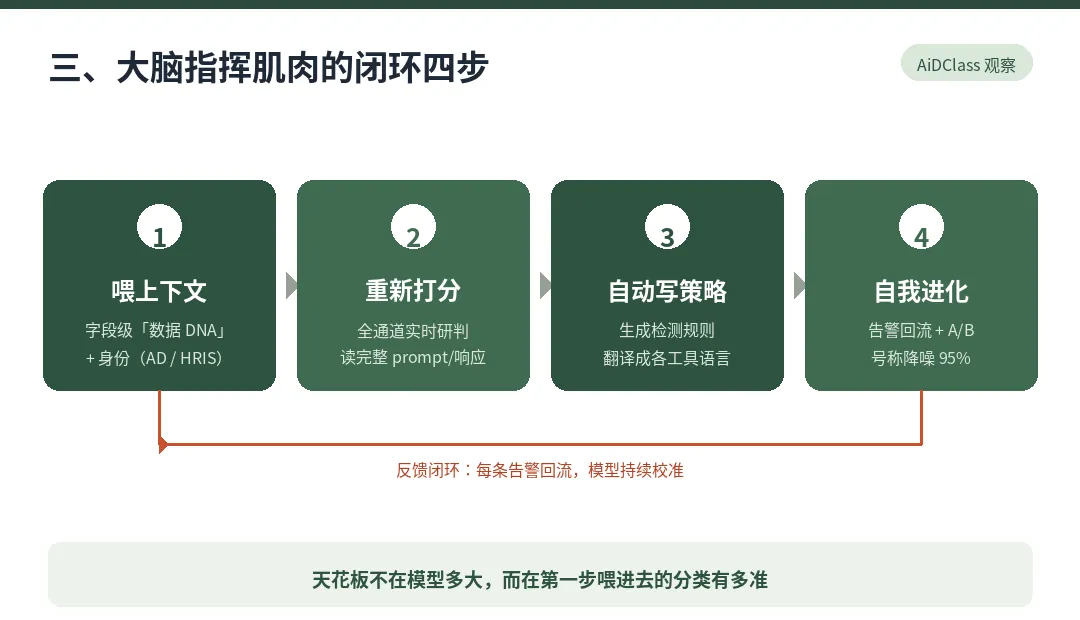
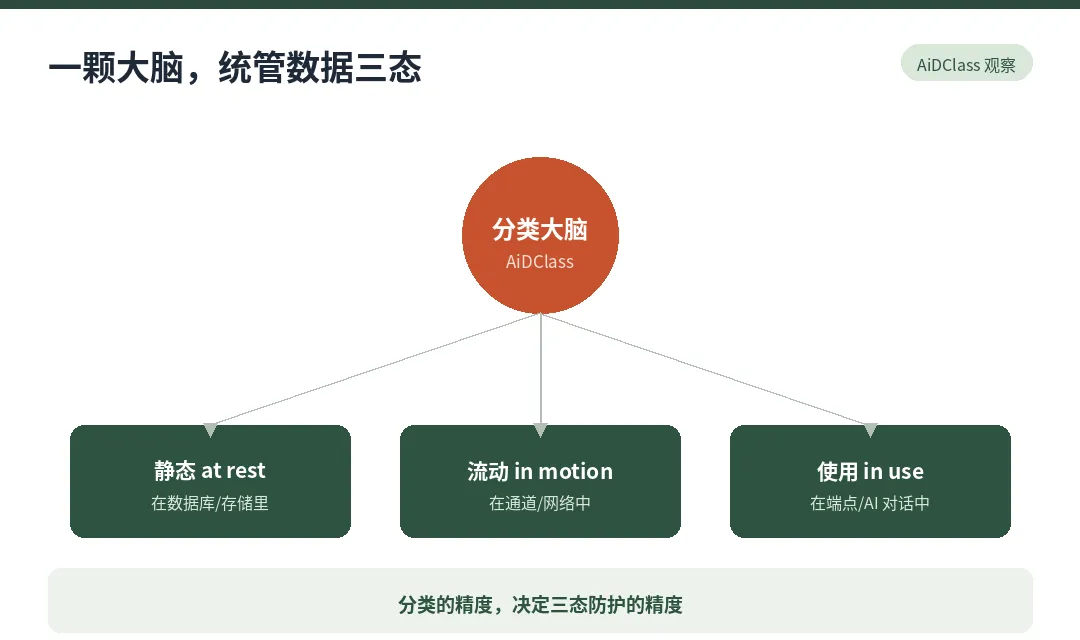
把这四步连起来看,你会发现一件事:决定整套系统天花板的,不是模型多大、拦得多狠,而是第一步喂进去的分类有多准。分类错了,拦截就是无的放矢;分类粗了,误报卷土重来;分类更新慢了,新业务新数据形态就成了盲区。大脑再聪明,喂进去的认知是糊的,指挥出来的动作也是糊的。
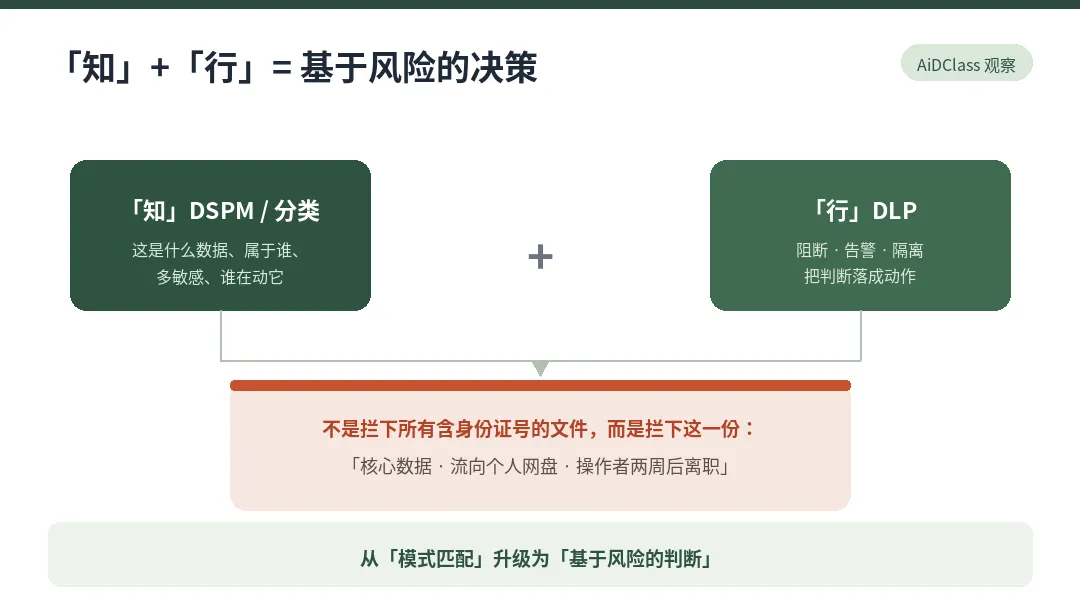
这也解释了 DSPM 与 DLP 为什么必须合在一起:DSPM 供「知」——这是什么数据、属于谁、多敏感;DLP 供「行」——阻断、告警、隔离。两者接上,判断就从「拦下所有含身份证号的文件」这种模式匹配,升级为「拦下那一份被标记为核心数据、正流向个人网盘、操作者两周后离职的文件」这种基于风险的判断。
四、这正是 AiDClass 在做的事——对标那块「数据 DNA」
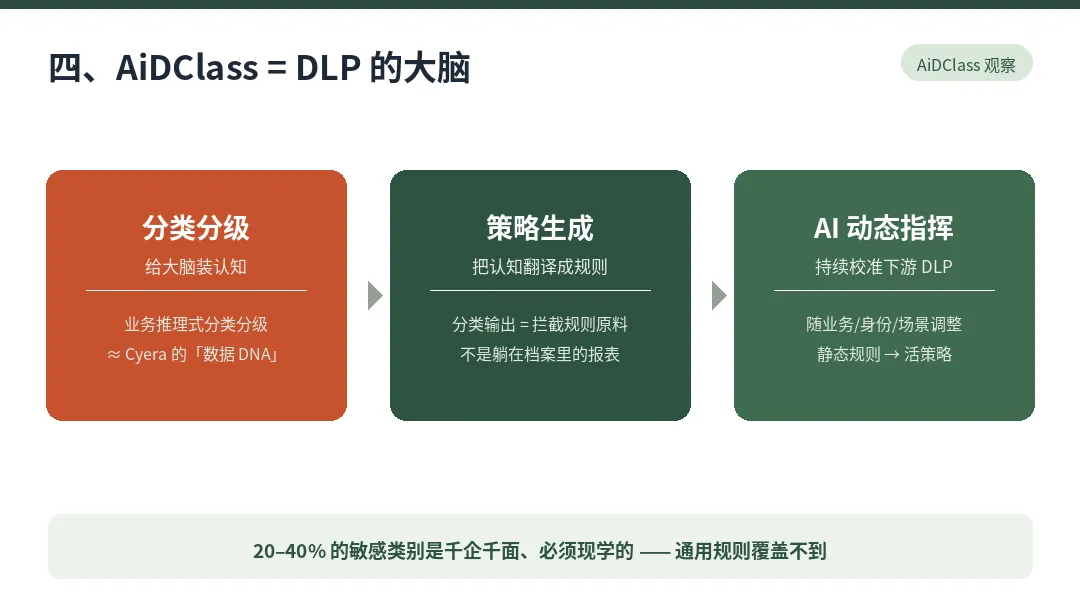
讲到这里,AiDClass 的位置就很清楚了。如果把 Omni DLP 拆成「数据 DNA / 策略大脑」和「下游执行工具」两半,AiDClass 做的,正是前面那半——给 DLP 装上能理解数据的大脑。
三段几乎是一一对应的。其一,分类分级 = 给大脑装认知。 AiDClass 是业务推理式的分类分级,先把「这是什么数据、对这家机构意味着什么」回答到专家级精度,对应的就是 Cyera 的「数据 DNA」那一层。其二,用分类结果快速构建策略 = 把认知翻译成可执行的规则。 分类的输出不是一张躺在合规档案里的报表,而是直接喂给 DLP、生成拦截规则的原料。其三,AI 分析 + 反馈 = 动态指挥 DLP 干活。 在分类底座之上叠加 AI 的研判与持续校准,DLP 就能从静态规则升级为随业务、身份、场景动态调整的活策略。
Cyera 那个 20%–40% 的数字,反过来恰好印证了我们的判断:通用规则永远覆盖不全,真正值钱、也最敏感的那部分数据,是千企千面、必须靠业务推理现场学出来的。这正是 AiDClass 把「业务推理式分类分级」作为切入点的原因——不是因为分类分级是一项要交差的合规作业,而是因为它是整个数据安全运营的地基:「知」的精度,决定「行」的精度。
五、别只听厂商口径:落地真正的坎
说了这么多机制的好,也得把另一面摆出来——否则就成了替 Cyera 写软文。报告里那些漂亮数字(降噪 95%、误报压到 90% 以下)都没有第三方验证,看个方向就好。
真正的难点,报告自己也承认。一是策略冲突:如果 Purview 和 Omni 同时在跑,同一个场景下听谁的?二是变更管理:这不只是上一套新技术,而是要重排工作流、重新划分团队职责、退役旧系统,对大企业是个跨周、跨月的项目。务实的做法是先让新大脑跑在「审计模式」下做对照,证明准确率之后再灰度切换执行,最后才逐步退役旧工具。三是过渡期的混乱:两套系统同时告警,需要人去调和。
对国内读者,还有一句更要紧的提醒:分类分级如果只当成一次性的合规交付,那这颗大脑就是空的。它得「活」在策略里、能被持续喂养和更新,才有意义。一份做完就归档、半年不动的分类清单,指挥不了任何拦截。
六、写在最后:策略的精度,长在分类的精度上
上一篇我们说,执行力的上限取决于认知的精度。这一篇可以再往前推一步:当认知——也就是分类分级——足够精确、而且能动态更新时,DLP 策略就能从「人工调规则的永恒苦役」,变成一套自己生成、自己进化的活体。
DLP 喊了三十年「防止数据丢失」,缺的从来不是拦截的手,而是理解数据的脑。给它一颗会持续学习的分类大脑,它才知道——这一次,到底该出哪只手。
参考资料
[1] SACR(Software Analyst Cyber Research): Building the Intelligence Layer for the Next Wave of Data Loss Prevention(2025.6,由 Cyera 支持)
[2] Cyera 官方新闻稿: Cyera Launches Omni DLP(2025.4)
[3] Cyera Blog: DSPM vs DLP — Rethinking Data Security in the Age of AI(2025.7)
[4] Cyera 官方新闻稿: Cyera Acquires Trail Security for $162M(2024.10)
[5] Forrester: The State of Data Security(2024.7)
—— 模界数智
相关解决方案
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流