RTX 4080 16GB 本地跑 Qwen3.8-27B:从 12.5 到 75 tok/s
本文原载于微信公众号,原题《一张4080,真的能跑动Qwen3.8 27B吗?从 12.5 tok/s 到 75 tok/s》。
副标题:从 12.5 tok/s 到 75 tok/s,看一张小显卡怎样跑动 27B 大模型
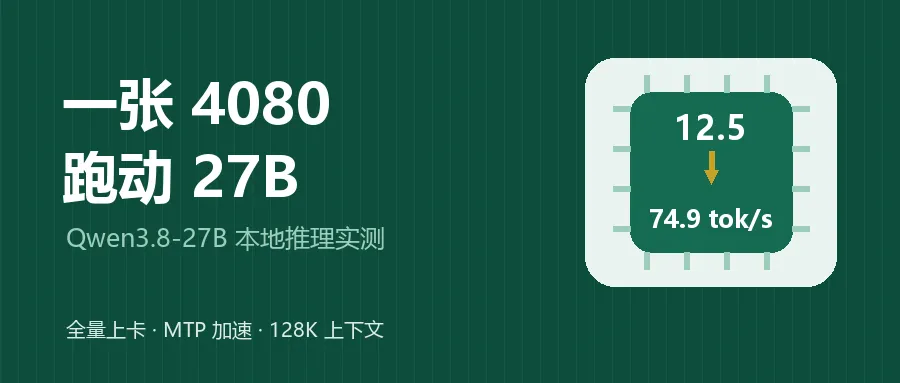
本文数据来自 RTX 4080 SUPER 16GB 单卡实测,测试时间为 2026 年 8 月 19—22 日。模型为 Qwen3.8-27B(GGUF),推理后端为 llama.cpp 的 llama-server。
一张 16GB 显存的 4080,能不能跑一个 27B 大模型?
如果只是把聊天窗口打开,让模型回答一句“你好”,答案并不重要。真正有价值的问题是:它能不能在本地连续读文件、调用工具、生成文档,完成一项真实工作?
我做的测试就来自这样一个场景。
这是一个部署在客户内网的售前文档平台。它要读取项目背景、会议纪要和招标文件,再生成方案书、交流 PPT 和标书应答。因为原始材料不能离开客户网络,模型必须在本地运行。
生产环境有两张 A5000,但开发机只有一张 RTX 4080 SUPER 16GB。开发机能不能顺畅运行,直接决定这套架构是否具备低成本复制的可能。
结果是:能。
但不是把模型下载下来、点一下“启动”那么简单。
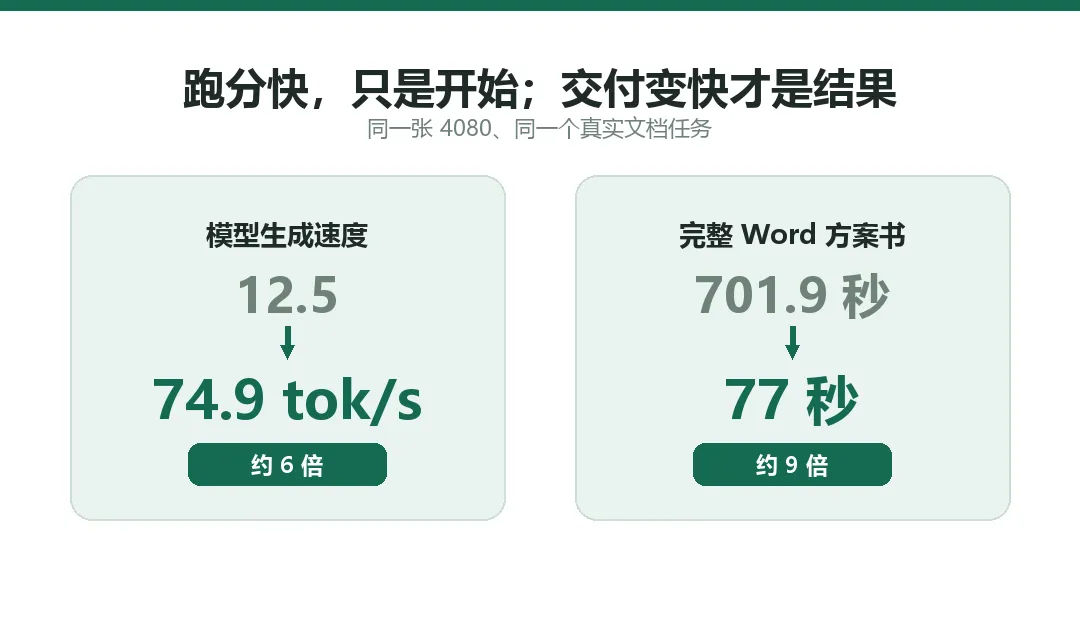
最终,这张 4080 把 Qwen3.8-27B 的生成速度从 12.5 tok/s 提升到 74.9 tok/s,完整生成一份 Word 方案书的时间也从 701.9 秒缩短到了 77 秒。
这篇文章不打算复述全部调参过程,而是讲清楚三个问题:为什么一开始跑不动,真正有效的调整是什么,以及普通读者如何复现。
一、先别只看速度:模型“会不会做事”更重要
最开始,我选择的是 gemma4:26b。
它的速度很好看:即使把上下文窗口拉到 128K,生成速度仍有 68—83 tok/s。单看跑分,它几乎就是理想答案。
但一进入真实任务,问题马上暴露出来。
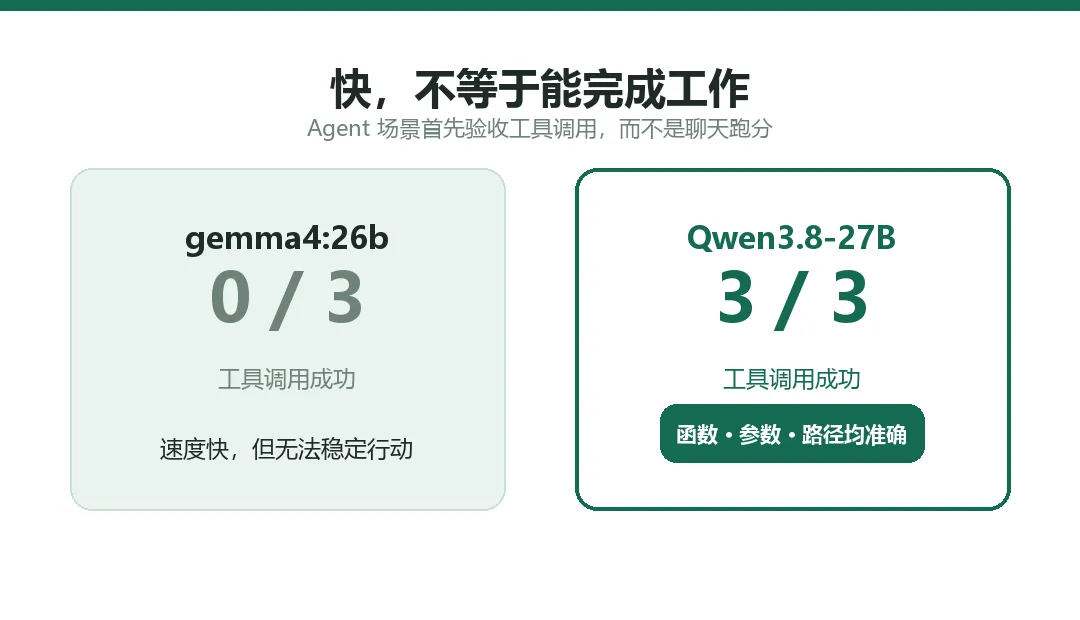
平台不是让模型单纯聊天,而是要求它调用工具:读取文件、执行脚本、把结果写入指定路径。面对同一条明确指令,gemma4:26b 连续三次都没有正确调用工具;qwen3.8:27b 则三次全部成功,连文件路径都没有写错。
| 模型 | 工具调用结果 | 实际表现 |
|---|---|---|
| gemma4:26b | 0/3 | 调错工具或直接跑题 |
| qwen3.8:27b | 3/3 | 正确调用工具,参数与路径准确 |
这件事改变了模型选择的标准。
在 Agent 场景里,“会不会正确使用工具”比“聊天时每秒多生成几十个字”更重要。一个跑得快但不会行动的模型,不能成为生产力工具。
于是,我换成了 Qwen3.8-27B。
代价也很直接:它在 64K 上下文下只有约 12.5 tok/s。这个速度用来聊天尚能忍受,用来完成几十轮工具调用就非常吃力。一份文档任务不仅慢,还可能因为等待过久而超时。
所以,后面的目标不再是“让 27B 模型启动”,而是“让它在真实工作流里可用”。
二、为什么 16GB 显存跑 27B,慢的往往不是显卡
很多人看到“27B 模型 + 16GB 显存”,第一反应是显存不够。
这个判断只对了一半。
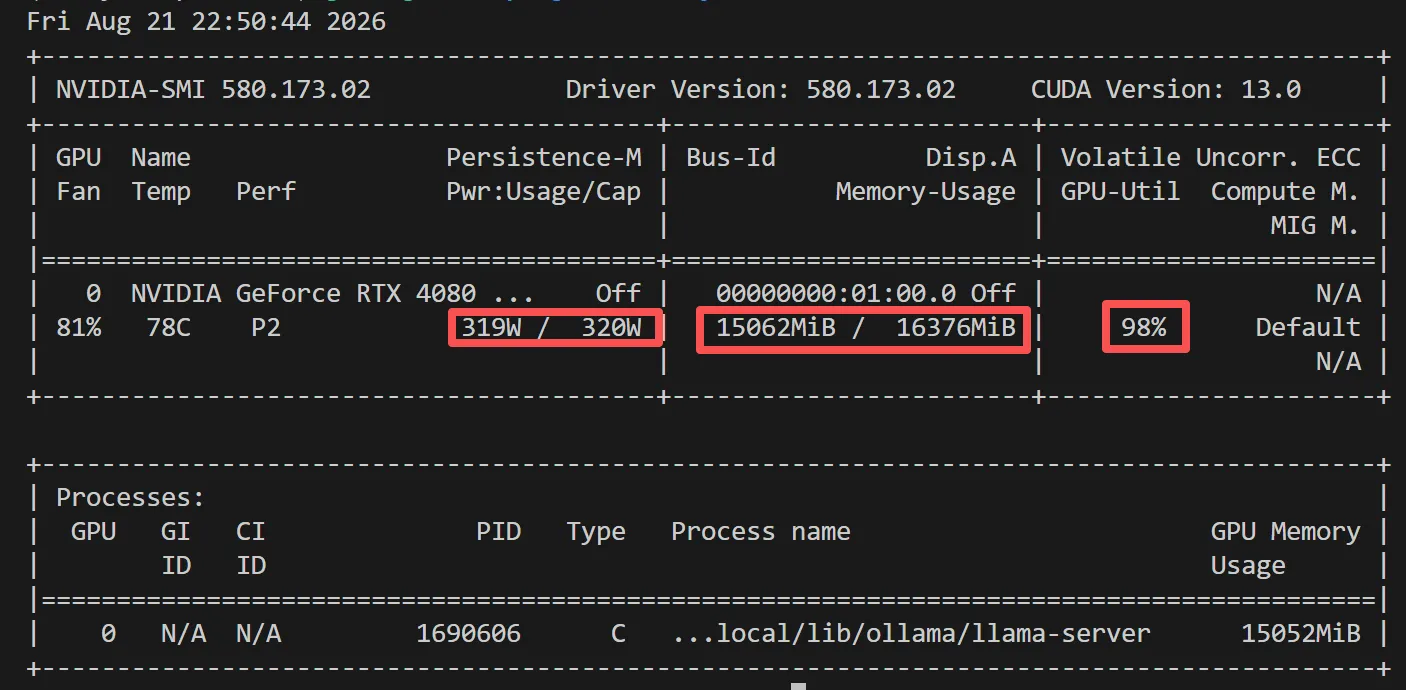
27B 代表模型大约有 270 亿个参数。经过量化之后,模型权重可以明显缩小,但常见的 Q4 量化版本仍有 15.66 GiB。再加上运行时缓存和计算空间,16GB 显存无法把它完整装下。
结果就是:大部分层在显卡上运行,剩下的层留在 CPU。
这看起来像一种合理分工,实际上却是速度陷阱。模型每生成一个 token,都要反复经过这些留在 CPU 的层,并在内存与显存之间搬运大量数据。4080 的计算能力没有被充分利用,整条流水线反而在等内存传输。
在最初的 Q4_K_M 配置中,65 层里有 13 层留在 CPU。每生成一个 token,大约要从内存读取 2.8GB 数据。按约 50GB/s 的内存带宽计算,仅数据搬运就需要约 56 毫秒,而当时生成一个 token 的总耗时约为 79 毫秒。
真正拖慢推理的,不是 4080 算不动,而是模型没有完整进入显卡。
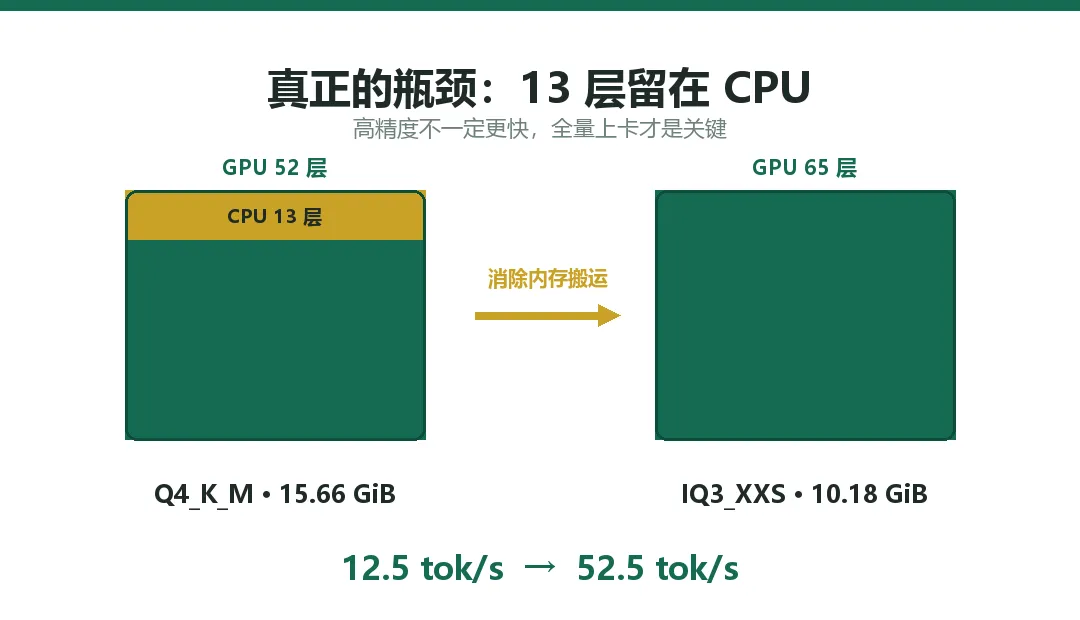
这也是整次调优最关键的认知转折:与其守着更高精度的量化版本,让一部分模型长期跑在 CPU 上,不如再压缩一档,把整个模型一次性装进显存。
三、真正有效的三步:全量上卡、关闭思考、打开 MTP
最后的提升不是来自某个神奇参数,而是三个动作叠加后的结果。
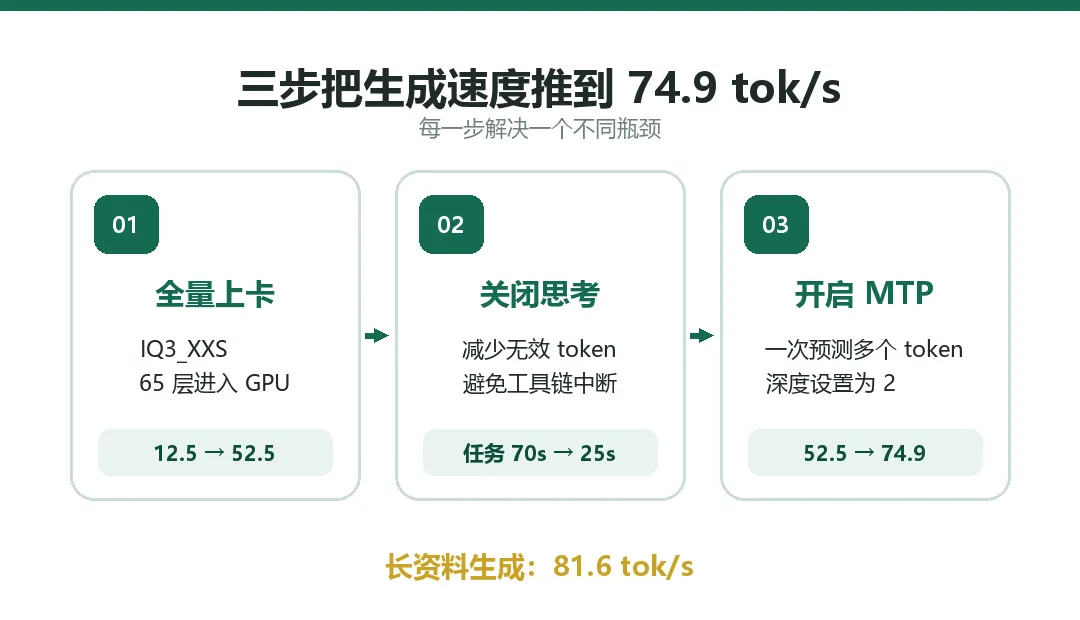
第一步:换用 IQ3_XXS,让模型全量上卡
我把 15.66 GiB 的 Q4_K_M 权重,换成了 10.18 GiB 的 IQ3_XXS 权重,并通过 -ngl 99 让模型全部进入 GPU。
变化非常明显:生成速度从 12.5 tok/s 提升到约 52.5 tok/s。
这里的 tok/s 可以简单理解为模型每秒生成多少个 token。中文里一个 token 并不严格等于一个汉字,但可以把它视为输出速度的近似指标。12.5 tok/s 是“能用但总在等”,50 tok/s 以上已经接近流畅工作。
很多读者会担心:从 Q4 降到 Q3,模型能力会不会明显下降?
我没有用“感觉差不多”来判断,而是测试了工具调用、严格 JSON、多约束指令、长文生成、知识库取材,以及 4.5 万 token 语料中的细节检索。四种量化档位在这些项目中都通过了。
完整生成的方案书也保持在 12 页、23 个标题、4 张表格,技术参数逐字一致。差异主要出现在模型自由撰写的行业痛点段落,而不是事实和结构。
这不等于 Q3 在任何任务中都与 Q4 完全相同,但至少说明:在这条售前文档生产线上,降低一档量化带来的能力变化没有越过可感知、可验收的边界。
量化档位不是越高越好。对于显存紧张的设备,“能否全量上卡”往往比 Q3 还是 Q4 更影响最终体验。
第二步:关闭不必要的思考过程
Qwen3.8 默认会进行思考。对复杂推理任务,这可能有价值;但在工具调用和按模板生成文档时,过长的思考会消耗 token,也会拉长每一轮操作。
实测中,不显式关闭思考时,一次任务生成了 566 字思考内容,总耗时 70 秒;关闭后,耗时降到 25 秒。
更重要的是,在当前平台调用链中,模型有时会在工具返回后只输出思考内容,却不给出可见正文,平台因此判断任务没有继续推进。
因此,最终配置使用 -rea off 关闭思考。
这不是说所有场景都应关闭思考,而是要根据工作类型选择:复杂规划可以保留,稳定的工具调用和结构化生产则更需要速度与确定性。
第三步:使用模型自带的 MTP 做投机解码
Qwen3.8-27B 的权重中带有 MTP(Multi-Token Prediction,多 token 预测)能力。通俗地说,普通推理像一个字一个字往前写;MTP 会一次提出多个候选 token,再由模型快速验证,猜对就整段接受。
它并不会让模型“少想”,而是减少了逐 token 生成时的重复计算。
开启 MTP、把预测深度设为 2 后,短提示生成速度从约 52.5 tok/s 进一步提升到 74.9 tok/s;输入较长资料后,生成速度甚至达到 81.6 tok/s。
长上下文反而更快,是因为这类任务通常是“给定材料,再按结构整理”。输出的可预测性更强,MTP 的候选更容易被接受。
对于资料抽取、报告装配和知识库问答,投机解码并非跑分技巧,而是与任务形态高度匹配的加速方式。
四、从 12.5 到 74.9,关键不是调了多少参数
把整个过程压缩成一张表,会发现真正有用的决策并不多。
| 阶段 | 核心变化 | 生成速度 | 结果 |
|---|---|---|---|
| 起点 | Q4_K_M,13 层留在 CPU | 12.5 tok/s | 能启动,但真实任务过慢 |
| 全量上卡 | IQ3_XXS,全部进入 GPU | 52.5 tok/s | 消除 CPU 搬运瓶颈 |
| 开启 MTP | MTP 深度 2 | 74.9 tok/s | 再提升约 43% |
| 长资料生成 | 同一最终配置 | 81.6 tok/s | 更贴近实际文档任务 |
MTP 是否真的在工作,不能只看启动参数,还要看每个任务结束时的接受率。真实产线日志给出了更直接的证据:
| 任务 | 接受 / 生成 | 接受率 | 平均接受长度 |
|---|---|---|---|
| task 21 | 181 / 194 | 93.30% | 2.87 token |
| task 128 | 30 / 30 | 100.00% | 3.00 token |
| task 645 | 4882 / 5100 | 95.73% | 2.91 token |
| task 4163 | 1118 / 1166 | 95.88% | 2.92 token |
这些任务的投机接受率达到 93%—100%,平均一次可以接受约 2.9 个 token。相比之下,短闲聊任务的接受率只有约 0.33。也就是说,“给资料、按结构抽取和装配”的任务更容易预测,长上下文生成反而能够跑得更快。
MTP 的价值不只是“已经加载”,而是它在真实任务里连续命中了接近三个 token。
端到端结果比跑分更有说服力。
| 指标 | 调优前 | 调优后 |
|---|---|---|
| 生成速度 | 12.5 tok/s | 74.9 tok/s |
| 长上下文生成 | 10.8 tok/s | 81.6 tok/s |
| 真实工具调用 | 25 秒 | 5.5 秒 |
| 生成一份完整 Word 方案书 | 701.9 秒 | 77 秒 |
| 上下文窗口 | 32K,无法承载完整系统提示 | 128K 单任务窗口 |
从模型“能启动”到业务“能完成”,中间差的不是一次跑分,而是一整条工作链路的验收。
五、真正跑通之前,还有三处容易忽略的门槛
1. 推理后端要能承受多轮工具调用
最初使用 Ollama 的 OpenAI 兼容 /v1 接口时,单轮对话正常,多轮工具调用却会返回 500,错误信息为 no user query found in messages。
最后改用 Ollama 自带的 llama-server,直接加载同一份 GGUF 权重。模型没有变化,接口仍可按 OpenAI 兼容方式调用,但多轮工具对话和流式输出恢复正常。
这提醒我们:模型能否工作,不只取决于权重,还取决于推理后端、接口协议和上层 Agent 是否匹配。
2. 上下文不能只看配置数字,要看每个 slot 实际分到多少
平台加载系统提示和 64 个工具定义后,启动内容已经达到 33,525 token。因此 32K 窗口连完整启动都做不到,64K 只是最低门槛。
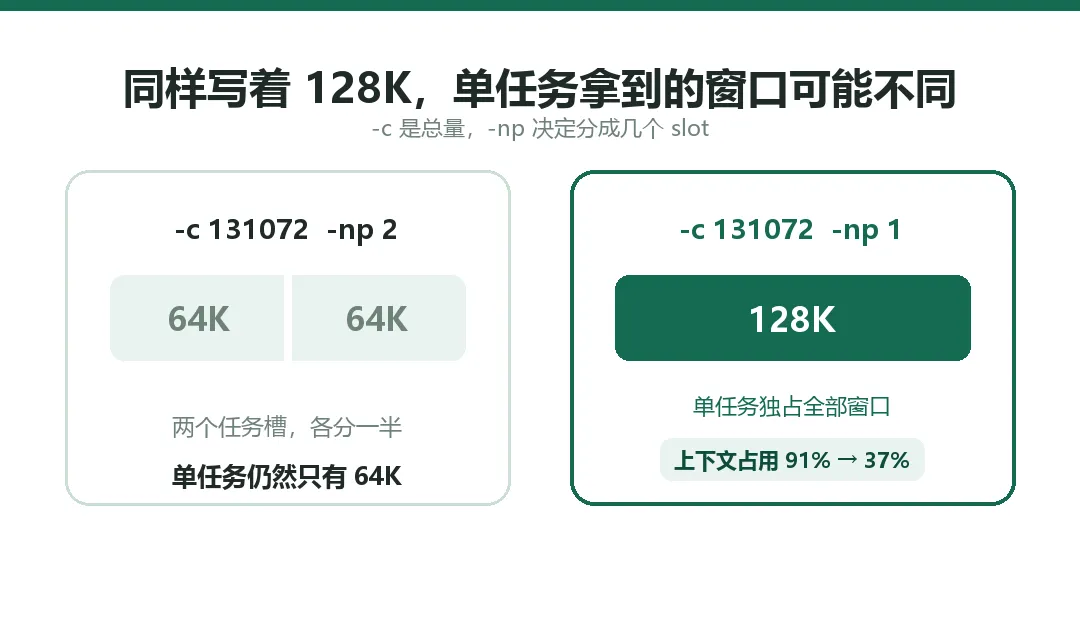
这里还有一个很容易踩的坑:llama-server 的 -c 表示所有 slot 共享的上下文总量,单个任务能用到的窗口约等于 -c / -np。
也就是说:
• -c 131072 -np 2,是两个 64K 窗口;
• -c 131072 -np 1,才是一个真正的 128K 窗口。
最终我选择单 slot,因为这个端点本来就是独占串行使用。改成真正的 128K 后,完整任务的上下文占用从接近上限的 91%,降到约 37%,端到端耗时也从 97 秒降到 77 秒。
启动后不要只相信配置文件,应回看日志。下面四行同时证明了三件事:主权重被正确加载、MTP 草稿上下文已经创建、单个 slot 确实拿到 128K。
load_model: loading model ‘Qwen3.8-27B-UD-IQ3_XXS.gguf’ common_speculative_init_result: creating MTP draft context against the target model srv load_model: initializing, n_slots = 1, n_ctx_slot = 131072 llama_server: model loaded
整份运行日志中,unused tensor 和 no usable GPU found 均为 0 次。运行时 /props 进一步返回:n_ctx = 131072、total_slots = 1、model_ftype = IQ3_XXS - 3.0625 bpw。
3. CUDA 后端路径写错,程序可能不会报错
GGML_BACKEND_PATH 必须指向具体的 .so 文件,而不是它所在的目录。
正确
GGML_BACKEND_PATH=/usr/local/lib/ollama/cuda_v13/libggml-cuda.so
错误:只指向目录,可能静默退回 CPU
GGML_BACKEND_PATH=/usr/local/lib/ollama/cuda_v13
最麻烦的是,路径写错后服务仍可能启动,只是速度慢得异常。启动日志中常见的线索只有:
warning: no usable GPU found
如果模型“能跑但慢得离谱”,第一件事不是继续改量化参数,而是确认它是否真的在使用 GPU。
六、如果你想复现,可以按这条最短路径走
本次实测机器使用 RTX 4080 SUPER 16GB、28 核 CPU 和 62GB 内存。CPU 与内存不必完全相同,但显卡需要留出足够空间容纳模型权重、KV cache 和计算缓冲区。
开始前只需准备三样东西:
-
安装了 CUDA 驱动的 Linux 环境;
-
Ollama 自带的 llama-server 及 CUDA 后端;
-
Qwen3.8-27B 的 IQ3_XXS GGUF 权重。
下面这组命令是最终使用的配置。模型路径需要替换成你自己的实际位置。
GGML_BACKEND_PATH=/usr/local/lib/ollama/cuda_v13/libggml-cuda.so
LD_LIBRARY_PATH=/usr/local/lib/ollama/cuda_v13:/usr/local/lib/ollama
/usr/local/lib/ollama/llama-server
-m /path/to/Qwen3.8-27B-UD-IQ3_XXS.gguf
—host 0.0.0.0 —port 11600
-ngl 99 -c 131072 —cache-type-k q4_0 —cache-type-v q4_0
-np 1 —load-mode none -rea off —no-mmproj
—spec-type draft-mtp —spec-draft-n-max 2
安全提醒:本次启动日志明确提示 CORS 允许所有来源且没有设置 API Key。这个配置只适合隔离的开发网络。正式环境至少应限制监听地址、配置访问控制,并通过防火墙或反向代理收紧访问范围。
服务启动后,可以先用一条最简单的请求确认接口正常:
curl http://127.0.0.1:11600/v1/chat/completions
-H “Content-Type: application/json”
-d ’{
“model”: “local-model”,
“messages”: [{“role”: “user”, “content”: “请用一句话介绍你自己”}],
“stream”: false
}’
如果能够返回正常内容,再继续接入 Agent 或文档平台。这样可以先把“模型服务是否可用”和“上层工具调用是否正确”分开排查。
不熟悉这些参数也没关系,只需要先理解五个关键点。
| 参数 | 通俗解释 | 验收方法 |
|---|---|---|
| -ngl 99 | 尽可能把模型全部放进显卡 | 日志中 CPU 侧 model buffer 应为 0 |
| -c 131072 | 给所有任务共 128K 上下文 | 与 -np 一起判断,不能单看这个值 |
| -np 1 | 只开一个任务槽,独占 128K | 日志应显示 n_ctx_slot = 131072 |
| -rea off | 关闭默认思考 | 工具返回后应继续输出可见内容 |
| —spec-type draft-mtp | 启用模型自带的多 token 预测 | 日志不应把 nextn 张量标记为未使用 |
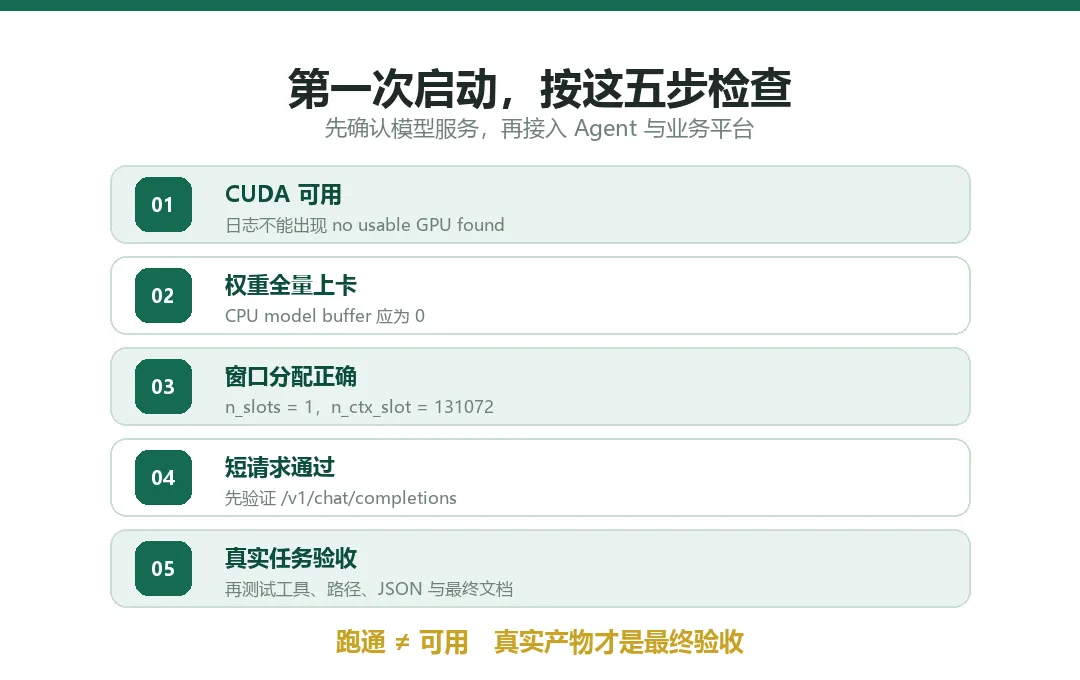
第一次启动后,建议按下面顺序检查:
-
看日志中是否出现 no usable GPU found;
-
确认 CPU 侧 model buffer 为 0,也就是权重已经全量上卡;
-
确认 n_slots = 1, n_ctx_slot = 131072;
-
先做一次短文本生成,再测试工具调用;
-
最后用一项真实任务验收,不要只看聊天速度。
如果只是普通聊天,64K 上下文已经很宽裕,可以把 -c 调低以节省显存。如果需要多个并发任务,则必须在 slot 数、单任务上下文和显存之间重新权衡,不能直接照抄单 slot 配置。
还有一个实际前提:在 128K 配置下,这张 16GB 显卡剩余约 1.4 GiB 显存,因此嵌入模型需要放在 CPU 上。实测 CPU 嵌入与 GPU 嵌入的余弦相似度为 0.997,热态单条耗时约 0.184 秒,对日常检索影响很小,但全量重建知识库会更慢。
七、速度上来之后,本地模型才真正成为生产力工具
调优完成后,我把同一个推理端点接给了 workbuddy,并用它开发了一个科学计算器应用。
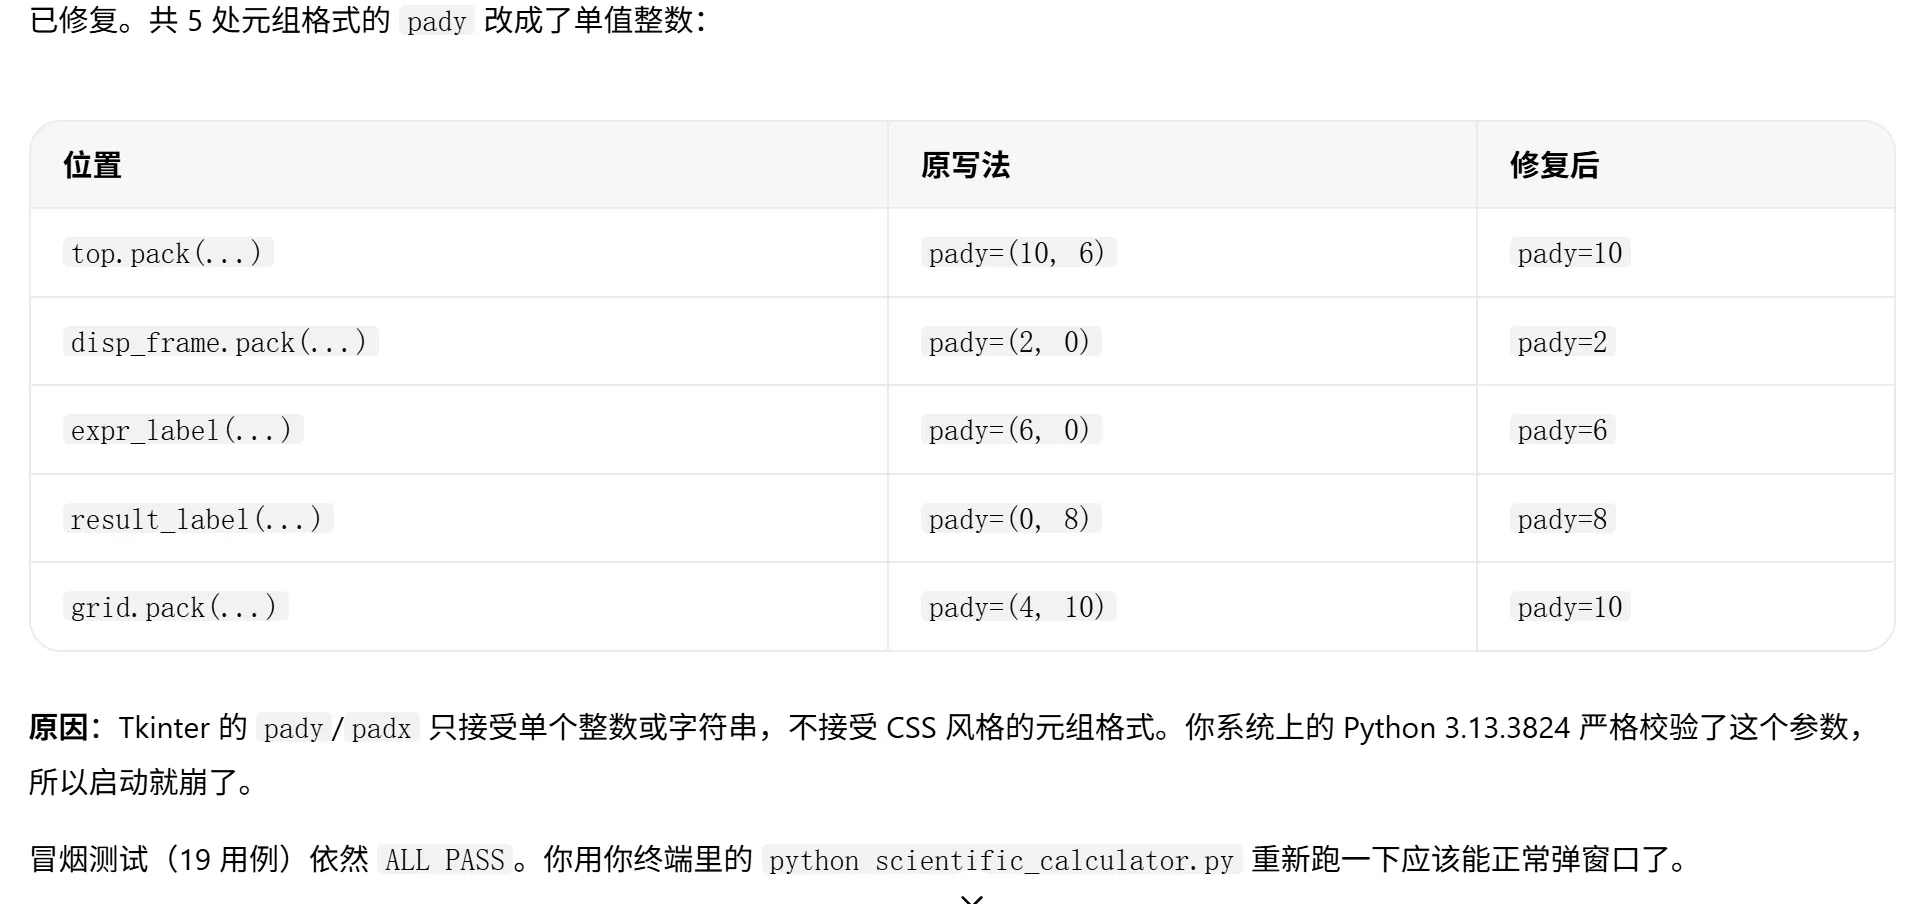
整个过程中只手动提出了两次调整要求。第一次,计算器因为 Tkinter 的 pady/padx 参数格式不兼容而无法启动。WorkBuddy 定位并修复了 5 处元组写法,随后跑完 19 个冒烟用例,结果全部通过。
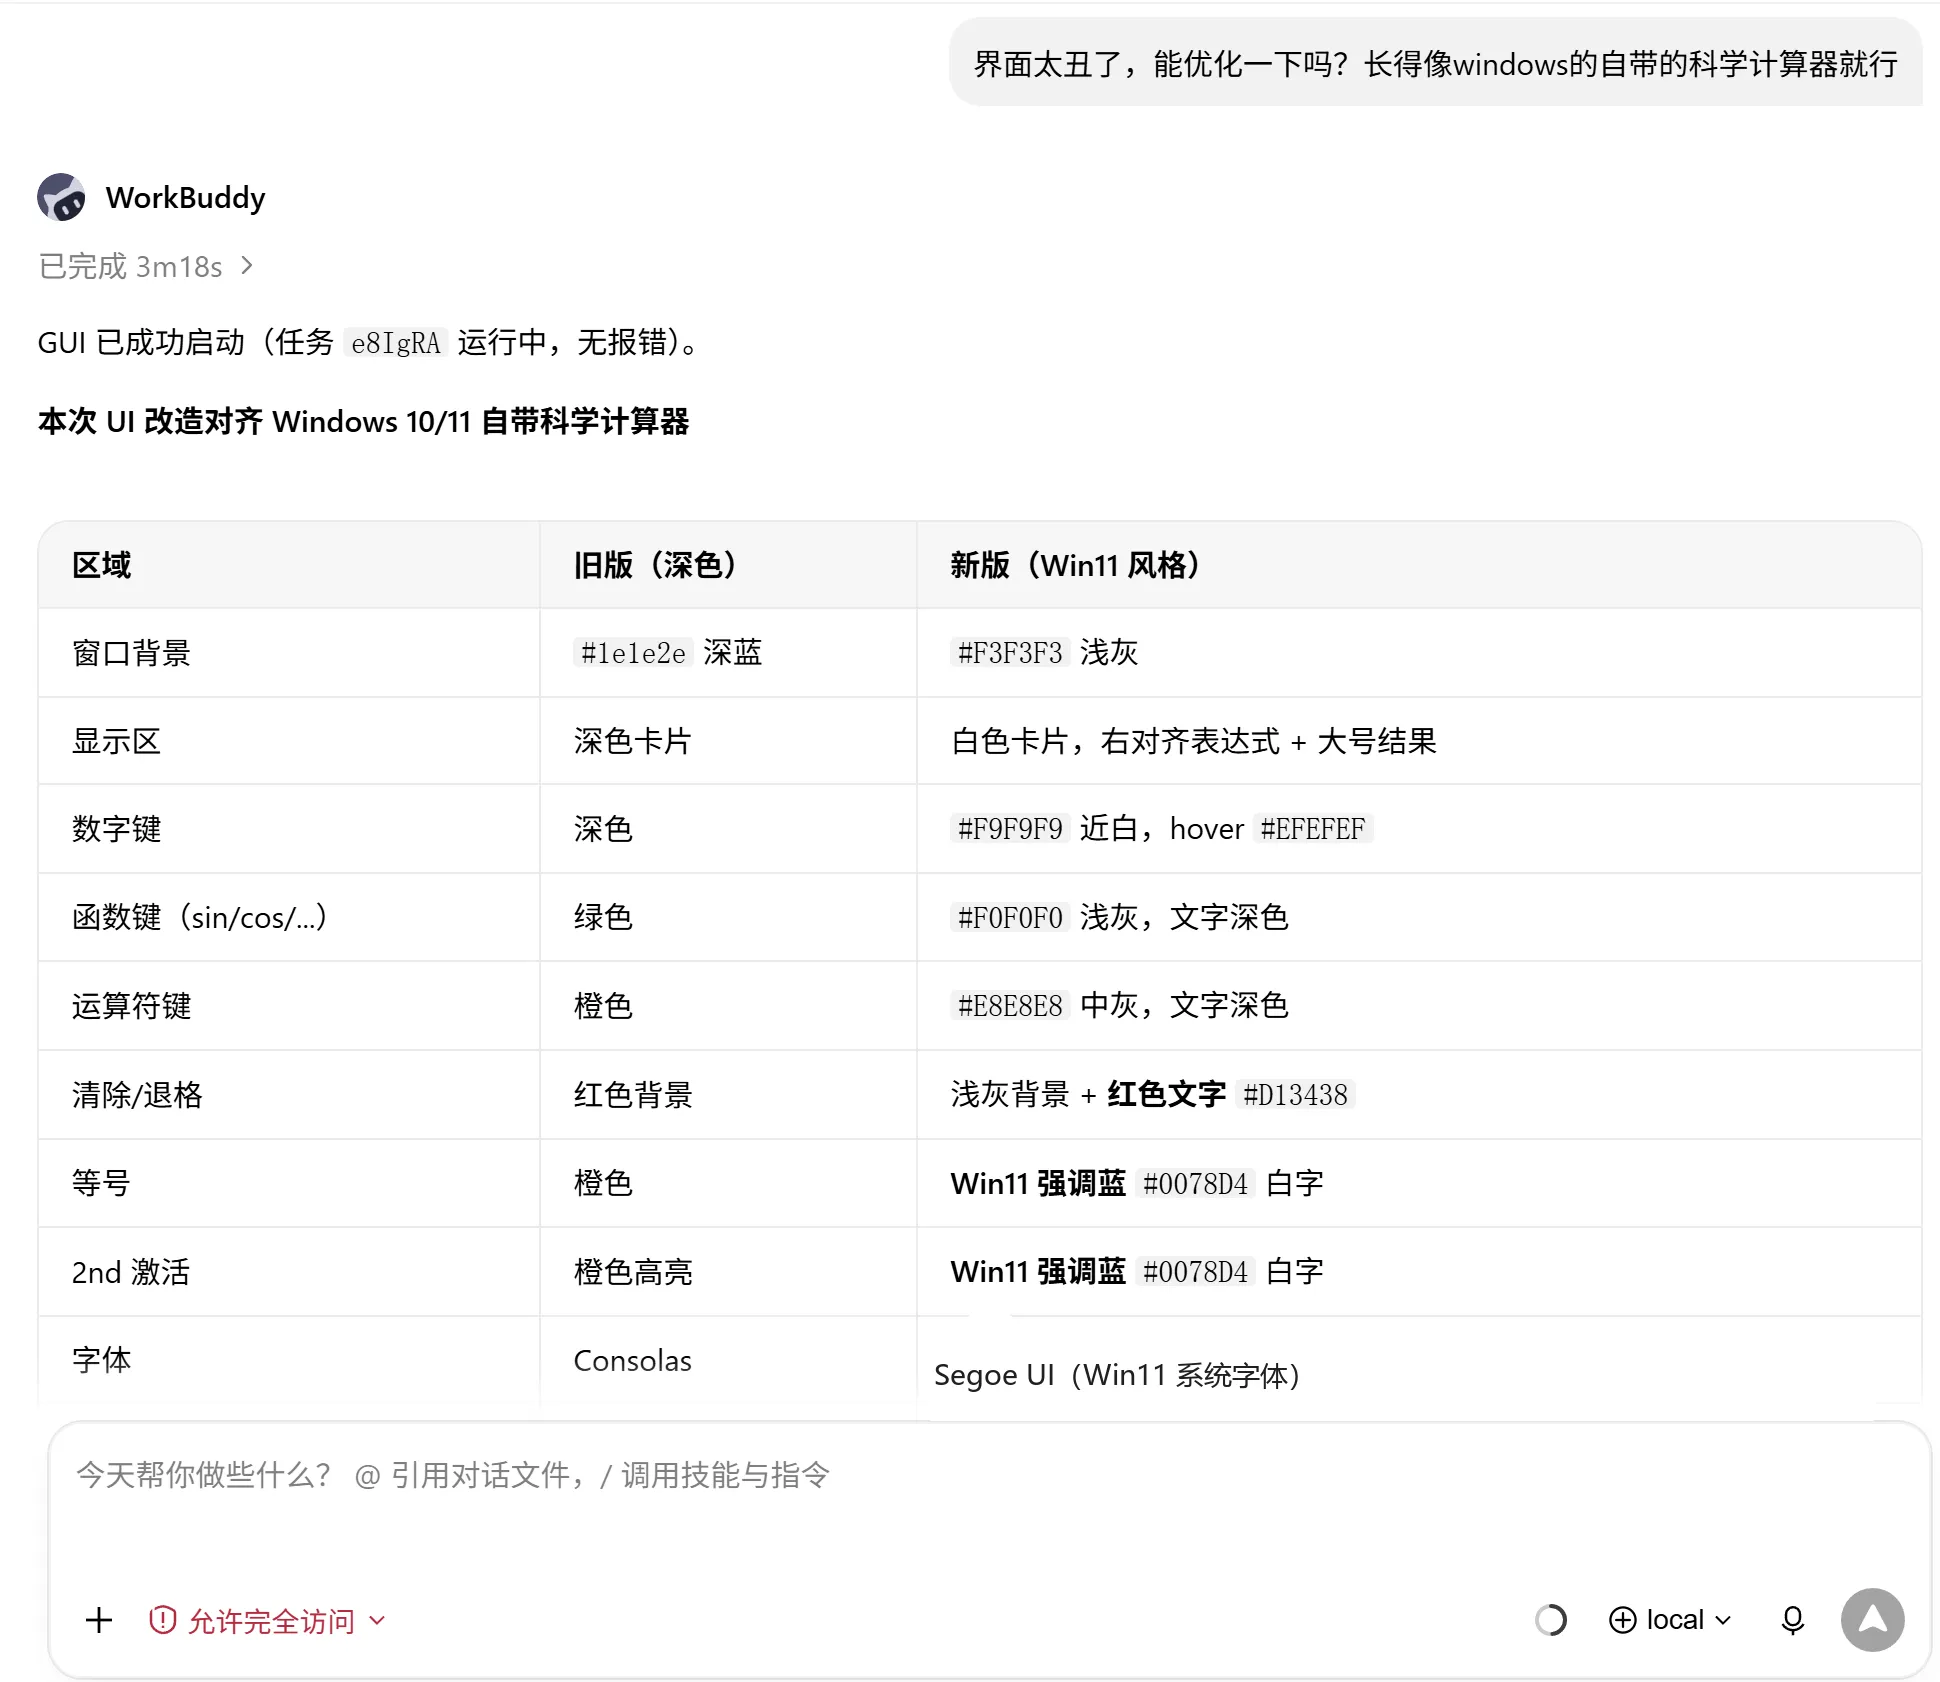
第二次,我提出“界面太丑,希望接近 Windows 自带科学计算器”。WorkBuddy 用 3 分 18 秒完成界面调整,包括窗口背景、显示区、数字键、函数键、运算符键和字体等视觉规则,并成功重新启动 GUI。
其余代码生成和迭代都由本地模型完成,最终得到下面这个可运行的科学计算器。
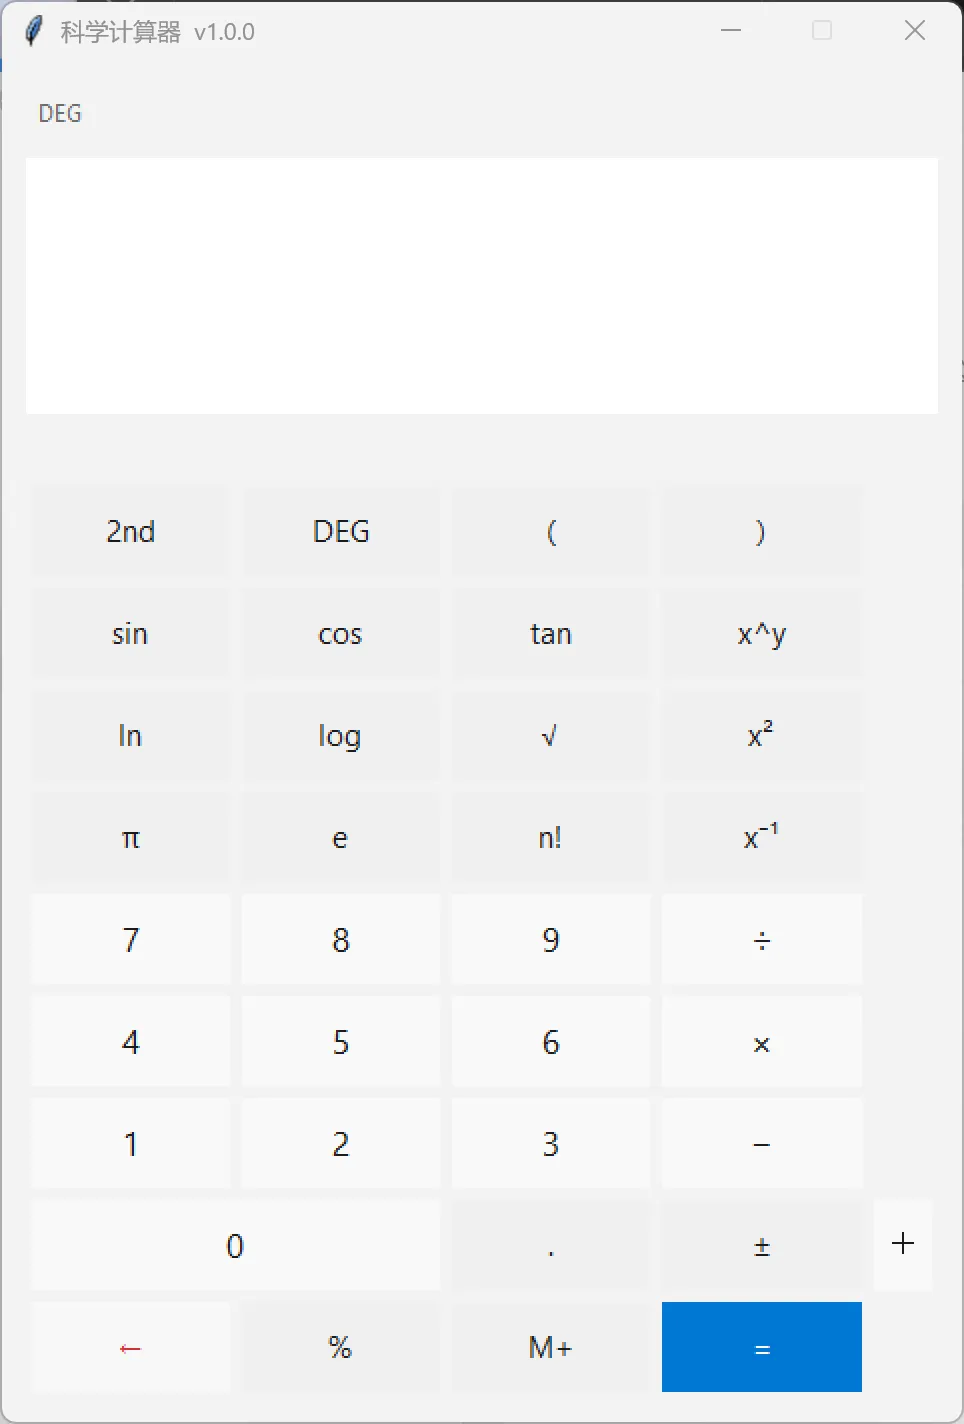
这张截图的意义不在于计算器本身有多复杂,而在于它证明了一件事:当生成速度从十几 tok/s 提升到七十多 tok/s 后,本地模型的角色会发生变化。
它不再只是一个“可以离线聊天”的演示,而是能在可接受时间内读文件、调用工具、修改代码和交付结果的工作节点。
本地部署的价值,从来不只是省下 API 费用。它让敏感材料留在边界内,也让企业有机会把模型真正接入自己的数据、流程与工具。
八、这次实践留下的五条经验
第一,先测“会不会做事”,再测“跑得有多快”。Agent 场景里,工具调用准确率是模型选择的第一道门槛。
第二,先判断瓶颈在哪里,再调参数。显存不够时,真正拖慢速度的可能不是模型太大,而是部分权重落在 CPU,造成持续的数据搬运。
第三,全量上卡的优先级可能高于量化精度。至少在本次文档生产任务中,Q3 全量上卡比 Q4 部分上卡快 6 倍,能力测试没有发现影响交付的差异。
第四,利用模型自身结构。Qwen3.8-27B 自带的 MTP 让生成速度再提升约 43%,而且资料越明确,收益越明显。
第五,必须用真实产物验收。工具名对不对、路径有没有写错、JSON 是否合规、文档是否完整,这些都比一段看起来不错的回答更可靠。
结语
一张 4080 跑 27B,大多数时候并不是“能不能”的问题,而是有没有找对瓶颈、有没有按真实任务验收。
硬件决定上限,工程决定你离上限还有多远。
当模型、数据与工具都留在本地,企业得到的不只是一个更快的离线助手,而是一条可控、可验收的智能生产链路。让数据留在边界内,也让数据真正开始为业务说话。
—— 模界数智 · FDE 团队
相关解决方案
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流