AI Agent 安全的六层防御栈:从模型到治理,你缺的是哪一层
本文原载于微信公众号,原题《不要被「包治百病」的 AI安全「忽悠」,给 AI Agent 设防,到底该设在哪一层?》。
副标题:护栏、网关、红队、guardrail……名词越堆越多,但 AI Agent 的防线其实是一条六层栈。看懂它,你才知道自己缺的是哪一层。
一、护栏很热,但你知道它该装在哪吗?
2026 年,几乎每一家安全厂商都在讲”AI Agent 安全”。Palo Alto、Cisco、Fortinet、CrowdStrike 在 RSAC 上轮番发布 agentic 产品,Lakera、Aim、WitnessAI、Prompt Security 这些 AI-native 初创则一家接一家被收购。新名词层出不穷:AI 网关、MCP gateway、guardrail、AI 红队、agent 治理……
如果把这些厂商铺到一张”保护焦点 × 部署形态”的二维图上,你能看清谁在哪个位置。但二维地图只回答了”谁在哪”,回答不了一个安全团队真正要问的问题:
我的 Agent 链路上,风险到底出在哪几个环节?我又该在哪几层设防?
更现实的是,很多安全负责人手里同时摆着三四份不同厂商的方案,每一份都自称”AI Agent 安全”,却用着完全不同的词、解决着完全不同的问题——有人在讲模型扫描,有人在讲提示词过滤,有人在讲工具授权。它们听起来在竞争,实际上往往根本不在同一层。
要厘清这件事,得换一个视角——不是平面的地图,而是一条纵向的防御栈。
二、Agent 安全不是一个点,是一条纵向流水线
先看一次 Agent 请求是怎么流动的:
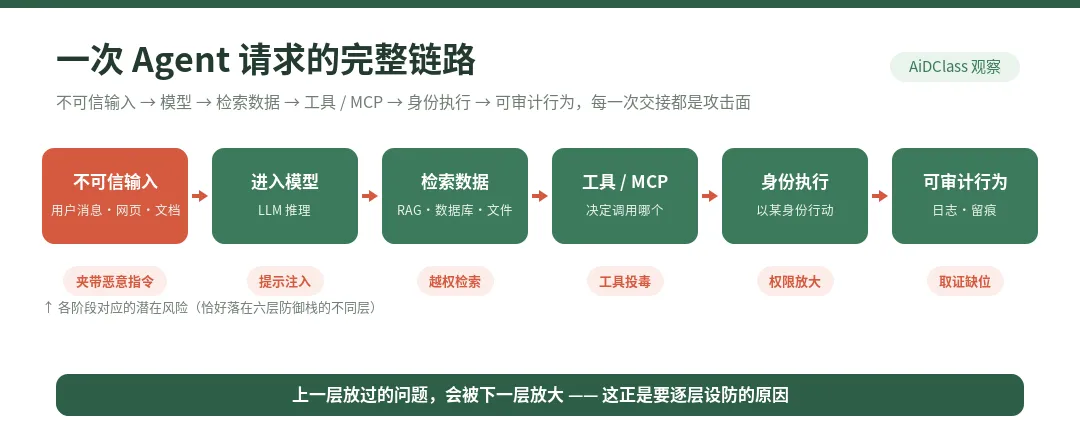
不可信输入(用户消息、网页、文档)→ 进入模型 → 模型去检索数据(RAG、数据库、文件)→ 决定调用哪个工具 / MCP server → 以某个身份真正执行动作 → 留下一串可被审计的行为。
注意:每一次交接,都是一个独立的攻击面。提示注入发生在输入到模型之间;数据越权发生在检索环节;工具投毒发生在 MCP 调用环节;权限放大发生在执行身份环节。
举个具体的例子:一个看似无害的”帮我总结这个网页并把要点存到工单系统”的指令,可能在网页正文里夹带了一段隐藏的恶意提示(间接注入),诱导 Agent 去读取它本不该碰的客户数据(数据层越权),再通过一个被投毒的工具描述把数据发到外部(工具层),而这一切都以一个权限过大的服务账号身份执行(身份层),事后却没有任何一条日志能还原是谁、动了什么(治理层缺位)。一次请求,串起了五层的风险。
传统安全的边界是平面的——一道网络边界、一个终端、一次登录。而 Agent 的风险是纵向叠加的:上一层放过的问题,会被下一层放大。所以真正成体系的 Agent 防护,是从下到上的六层防御栈。
三、六层防御栈,逐层拆开看
第 1 层 · 模型层。 风险来自模型本身:被投毒的开源权重、藏在模型文件里的恶意代码(用标准 API 加载模型即触发远程代码执行)、整条 ML 供应链。防法是模型扫描、来源校验与签名、沙箱化加载。代表玩家:HiddenLayer、Protect AI(已并入 Palo Alto 的 Prisma AIRS)、TrojAI。
第 2 层 · 数据层。 风险是喂进上下文和 RAG 的敏感数据被外送、检索越权、数据投毒。防法是 DSPM 做数据发现与分类分级、建数据血缘,再按等级决定”这条数据能不能进上下文、能不能进检索范围”。代表玩家:Cyera、Forcepoint(AI Mesh)、Varonis、BigID;其中 Knostic 专攻 LLM 的越权”过度共享”。
第 3 层 · 提示词 / 内容层。 风险是直接与间接的 prompt injection、越狱、敏感内容输出。防法是对输入输出做实时检测,给出放行 / 告警 / 拦截 / 脱敏。但这里要保持清醒:注入没有完美的检测方案——正如安全研究者 Simon Willison 引述的那句”The Attacker Moves Second”,任何静态防御,攻击者都能在你之后再出招。代表玩家:Lakera(已归 Check Point)、Netskope AI Guardrails、Aim Security、CalypsoAI(已归 F5)。
第 4 层 · 工具 / MCP 层。 这是当下最拥挤、也最关键的一层。风险是工具投毒(恶意指令藏在工具描述的 metadata 里,Agent 读得到、用户看不见)、MCP 流量被注入、未授权的工具调用。这不是纸面风险:MCPTox 基准测过 45 个真实 MCP server、353 个真实工具,多数主流 Agent 的攻击成功率超过 60%,最高到 72%;同期还出现了针对官方 Git MCP server 的实际利用链,以及大量”零认证暴露在公网”的 MCP server。防法是上 MCP 网关:工具白名单、参数过滤、响应消毒、OAuth 认证,并把 Agent→工具→MCP→外部服务整条链路做成可观测。代表玩家:Proofpoint(收购 Acuvity)、Netskope Agentic Broker、Prompt Security、Fortinet FortiAIGate。这一层的拥挤不是偶然——它正是”控制点上移”落到的新卡口。
第 5 层 · 身份层(Agent IAM)。 一个尖锐的问题:这个 Agent 到底以谁的身份在行动?风险是权限过大、长效凭证、跨会话越权。防法是给每个 Agent 一个独立、可验证、按工具和时限授权的身份——也就是”非人类身份”(NHI)的最小权限。代表动作:Cisco 用 Duo IAM 给 Agent 发可验证身份和时限权限。这一层整体还很薄。
第 6 层 · 治理与审计层。 风险是你根本不知道有多少 Agent 在跑(影子 AI),出了事说不清责任。防法是 Agent 发现与清点、交易级审计、对齐 OWASP Agentic Top 10、EU AI Act、NIST AI RMF 等框架。代表玩家:Microsoft Agent Governance Toolkit、CrowdStrike(从端点侧做 Agent 发现)、WitnessAI(身份绑定的审计追踪)。
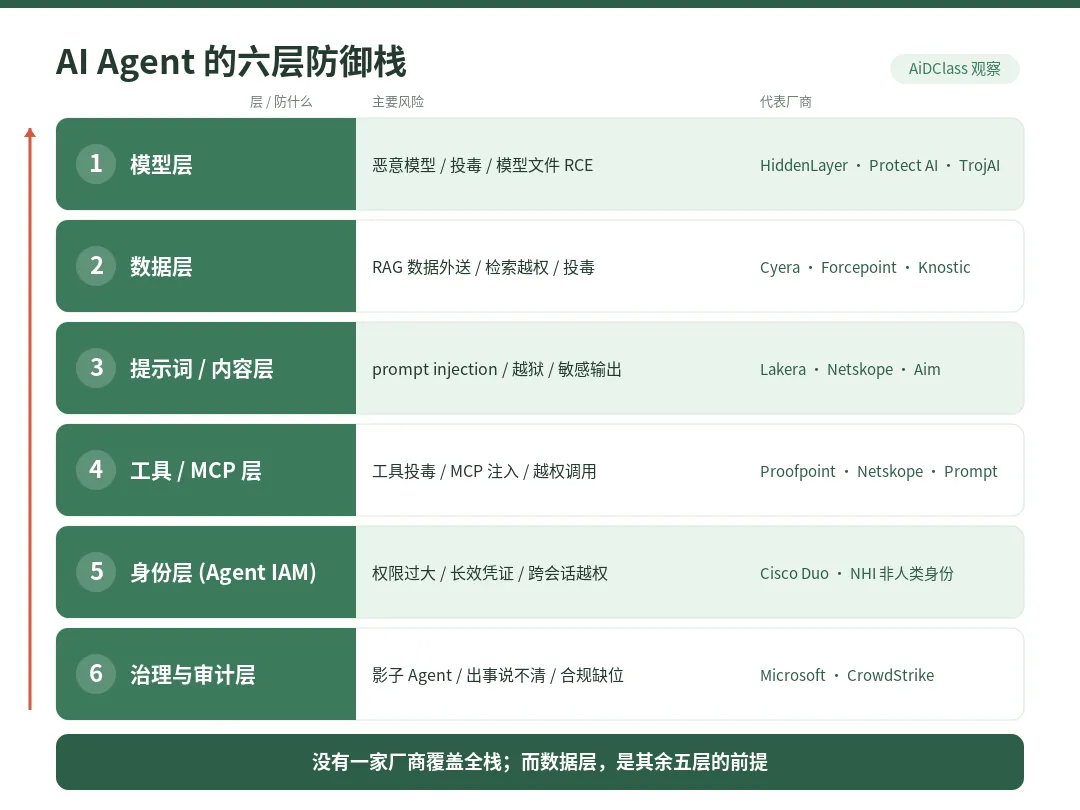
从模型到治理的六层防御栈
四、把厂商铺到这张栈上,两个结论很扎心
结论一:没有任何一家独立厂商覆盖全栈。 Cyera 守数据层,Lakera 守内容层,Proofpoint、Netskope 守工具层——每家都只占一两段。
结论二:这些能力是互补,不是替代。 你买了一个 MCP 网关,不等于解决了数据层的越权,也不等于给 Agent 配了身份。把”内容 guardrail”当成”全栈 AI 安全”,是选型里最常见的误判。
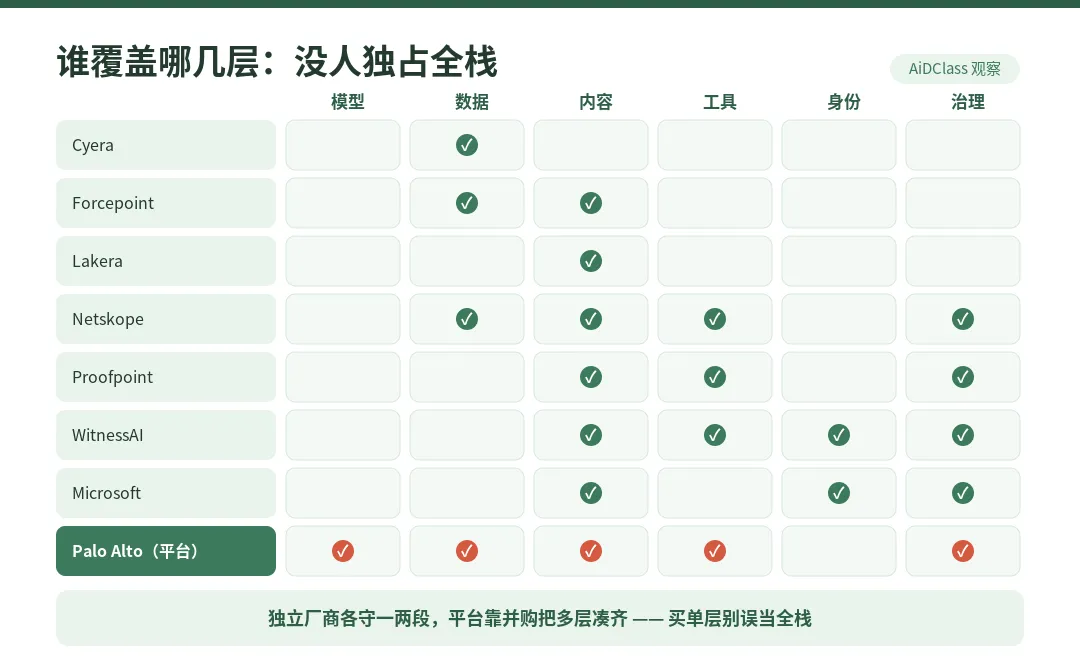
主流厂商各自覆盖哪几层
五、整合潮的真相:巨头在”把这六层买齐”
看一眼过去一年的并购,你会立刻明白平台巨头在干什么:
Protect AI → Palo Alto(补模型层)、Robust Intelligence → Cisco(补内容层)、CalypsoAI → F5(补内容 / 红队)、Lakera → Check Point(补内容层)、Acuvity → Proofpoint(补工具层)、Genie → Cyera(补数据层)。
平台巨头不是在做更好的”单层”,而是在用并购把六层一次性凑齐,卖一个”全栈 AI 运行时”。
这也顺带回答了行业一直在争论的问题——“AI 安全是一个独立赛道,还是各大平台的一个特性?” 目前的答案倾向于:通用的 guardrail、红队会被平台吸收成特性;而需要深度专精的层——模型供应链、Agent 身份、数据越权——更可能长成独立公司。
值得安全团队留意的一个连带后果是:当你今天选型的某个独立工具,很可能在一年内被某家平台收购、并入某个大套件。这未必是坏事,但它意味着选型时不能只看单点功能,还要看它落在哪一层、未来会被并进谁的栈——否则你今天精心拼起来的多厂商组合,明年可能因为一次并购而需要重排。市场也在公开寻找”AI 安全界的 CrowdStrike 或 Wiz”,但截至目前,还没有任何一家真正坐稳全栈的位置。
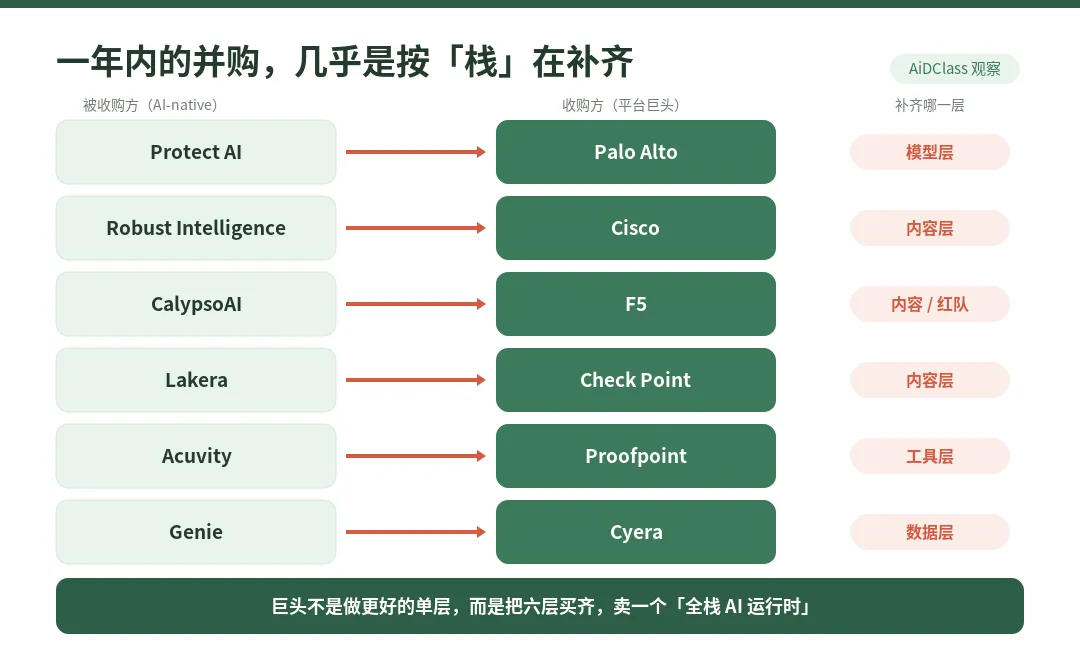
一年内的并购,几乎是按”栈”在补齐
六、贯穿全栈的两条暗线
暗线一:控制点在持续上移。 把安全史拉长看,拦截点一路往上走:网络层 → 端点层 → 身份层 → 数据层 → 如今的”意图与工具调用层”。栈越往上,越贴近语义,越难用规则穷举——这正是 MCP 网关成为兵家必争之地的原因。
暗线二:从”检测对抗”转向”能力围栏”。 既然承认注入防不住,前沿防御就把赌注从”更聪明的检测”挪到”即使被注入也限制危害”:Rule of Two(一个 Agent 单次会话里,“读不可信内容、碰敏感数据、改外部状态”三者最多取其二)、最小权限、纵深防御。这是从 appsec 的”找漏洞”到”假设已失陷”的范式迁移。
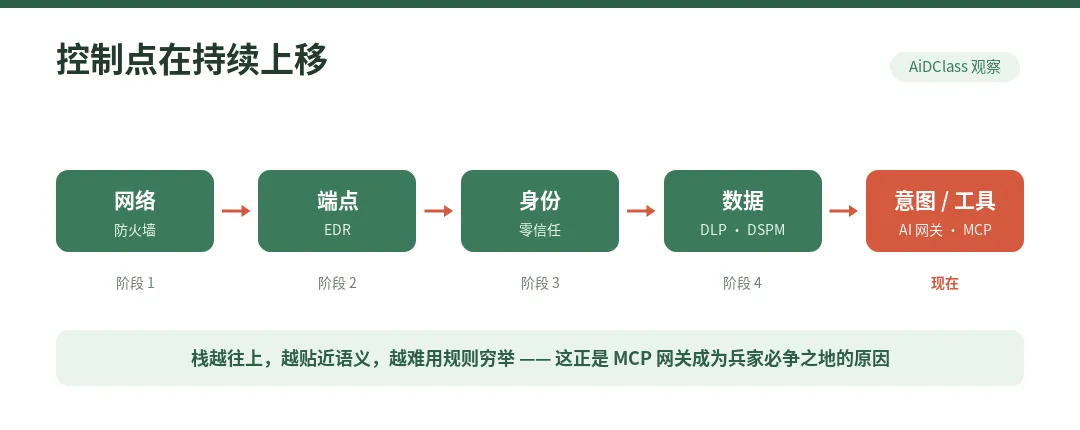
拦截点从网络一路上移到意图与工具
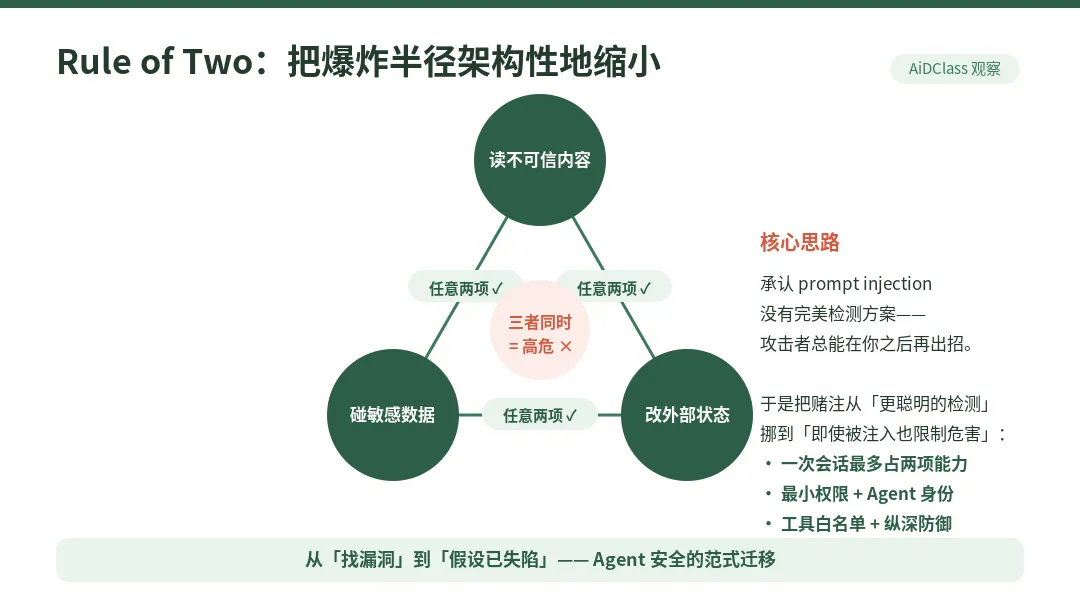
Rule of Two:把爆炸半径架构性地缩小
七、最薄的一层,也是方向:身份与行为基线
RSAC 2026 上,CrowdStrike、Cisco、Palo Alto 都发布了 agentic SOC 工具,但有一个共同缺口被反复点名:没人能给 Agent 建立”正常行为基线”。 人有行为画像(UEBA),Agent 还没有。
而 Agent 的数量,会比人多好几个数量级,它们之间互相调用、代表用户行动。这里面有一个被低估的事实:**Agent 用的大多是”非人类身份”(NHI)——服务账号、API key、**机器凭证,而这类身份在大多数企业里恰恰是治理最差的一块:长期不轮换、权限只增不减、出了问题没人认领。当成千上万个 Agent 各自背着一个权限过大的服务账号在企业里跑,传统那套围绕”人”建立的身份治理,第一次显得严重不够用。
谁能回答”这个 Agent 现在的行为正不正常、它被授权了没”,谁就站在了方向上。Knostic(防越权)、Zenity(Copilot / 低代码 Agent 治理)、WitnessAI(意图 + 身份)这些独立玩家,正是在卡这个尚未被巨头吃透的缝。换句话说,身份层和行为基线,既是今天最薄的一层,也是未来一两年最值得下注的方向。
八、给安全从业者:别买”银弹”,先补最缺的那一层
落地其实就三步:
第一,画出你自己的 Agent 链路,落到这六层上,看哪几层在裸奔。多数企业裸在数据层和身份层。
第二,按风险补,不按热度补。 MCP 网关很热,但如果你的数据层还没做分类分级,网关拦不拦得住,只是猜测。
第三,选型时认清每家覆盖哪几层,别把单层能力买成”全栈安全”的错觉。
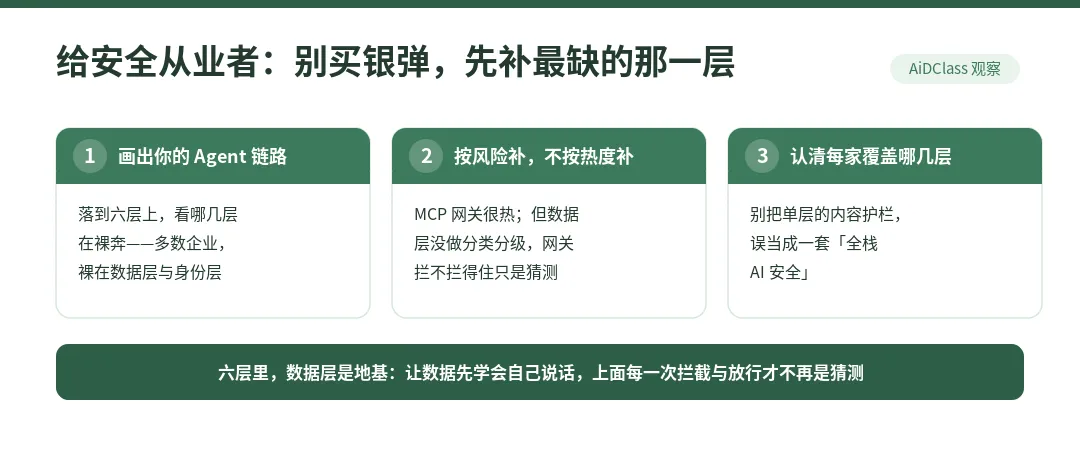
给安全从业者的三步落地
这三步落下来,你大概率会发现一件事:买得最多的,往往不是最该补的。内容层的 guardrail 因为演示效果好、最容易出 demo,常常被反复采购;而真正在裸奔的数据层和身份层,因为”看不见、不出彩”,反而一拖再拖。安全预算的分布,常常和真实风险的分布是反过来的。
而六层里,有一层是其余五层的前提——数据层。无论你在工具层设多严的网关、给 Agent 发多精细的身份,真正决定”这一次该不该放行”的,是系统能不能在毫秒之间回答:这条数据是什么、几级、属于谁、能不能进这个上下文。这个判断做不出来,上面五层的所有拦截,本质上都只是在赌。
这也正是 AiDClass 一直在做的那一环:给企业的每一条数据装上自动化的分类分级与语义身份。护栏可以层层叠加,但只有当数据先学会自己说话,上面那五层的每一次拦截与放行,才不再是猜测。
给 Agent 设防,设在哪一层都对。但别忘了:最底下那层数据,才是所有防线的地基。
参考资料
[1] Palo Alto Networks 完成收购 Protect AI,整合进 Prisma AIRS(2026.3)
[2] Proofpoint 收购 Acuvity,构建跨 Agent / MCP 的运行时安全(2026.2)
[3] Cisco 收购 Robust Intelligence;Duo IAM 为 Agent 提供可验证身份与时限权限
[4] F5 收购 CalypsoAI(2026.1);Check Point 收购 Lakera(2025)
[5] MCPTox 基准:真实 MCP 工具的提示注入攻击成功率普遍 >60%
[6] Simon Willison:《New prompt injection papers — Agents Rule of Two & The Attacker Moves Second》
[7] OWASP Top 10 for Agentic Applications(2025/2026);EU AI Act 高风险义务(2026.8 生效)
[8] VentureBeat:RSAC 2026,三大厂的 agentic SOC 与 Agent 行为基线缺口
—— 模界数智 · AiDClass 团队
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流