AI 时代的数据安全怎么建:打桩、浇筑、起结构、验收四道工序
本文原载于微信公众号,原题《面向未来的安全,从哪一根桩打起?》。
上篇说,两代安全的分水岭在最底层的隐含假设里。这一篇回答剩下的那个问题:面向未来的安全,到底怎么建?答案是一张施工图——四道工序,一道压一道。而第一道工序,恰恰是最容易被跳过的那道。
一、安全买不来,只能建
上一篇《你在做的安全,是面向过去的安全,还是面向未来的安全?》发出后,收到最多的追问是同一个:道理我认了,那到底怎么办?
先把最重要的一句话放在最前面:这绝不是采购一个工具、或者买一套所谓”大厂解决方案”就能解决的问题。安全买不来,只能建——要在系统构建的第一天,就把数据安全牢牢打进地基里。
为什么买不来?因为面向未来的安全要解决的,不是”再加一道墙”,而是”换一块根基”。市面上的 AI 网关、护栏、控制平面都是好材料,但材料堆在工地上不等于房子。真正缺的不是材料,是施工图——先干什么、后干什么、哪一步是哪一步的承重。
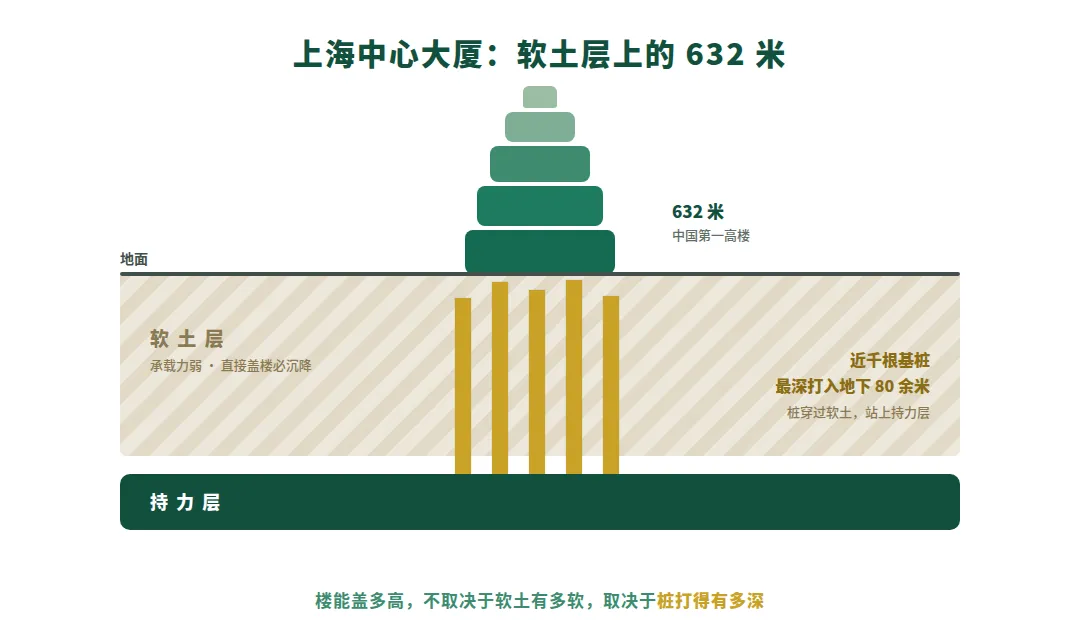
好消息是,这张施工图并不神秘。工程界处理”软地基上盖高楼”有一套标准打法:上海中心大厦建在软土层上,靠近千根桩打进坚硬的持力层,照样盖到 632 米。搬到数据安全上,就是四道工序:
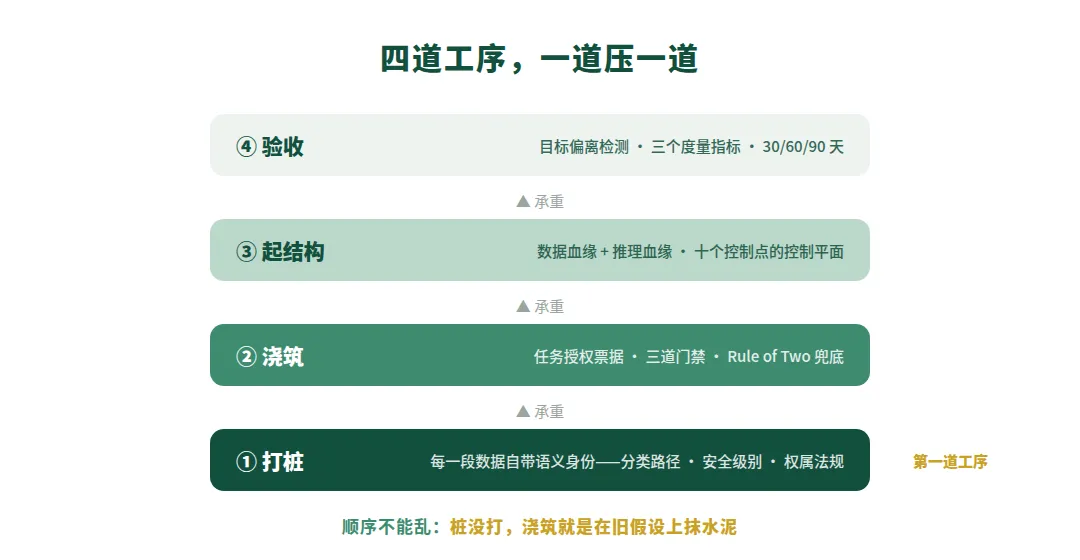
打桩 → 浇筑 → 起结构 → 验收。
顺序不能乱:每一道工序,都是下一道的承重。国际上的主流框架也在收敛到同一个方向——Gartner 的 AI 信任与安全框架(AI TRiSM)被普遍指出还缺”运行时执行”这最后一环,NIST 也刚刚开始研究 AI Agent 的身份与授权。没有谁落后,大家面对的是同一张刚开始画的图纸。
为了不让这四道工序停留在概念上,本文请一位”主角”全程出镜:一份《华东区机构客户清单.xlsx》——里面有客户名称、联系人手机号、合同金额,典型的高敏感数据。我们跟着它走完从入库到被 AI 使用的全过程,看看每一道工序在它身上到底发生了什么。
二、工序一 · 打桩:给每一段数据发一张身份证
第一道工序,也是最深的一道:让每一段数据,都带着一张说明自己是谁的”身份证”。
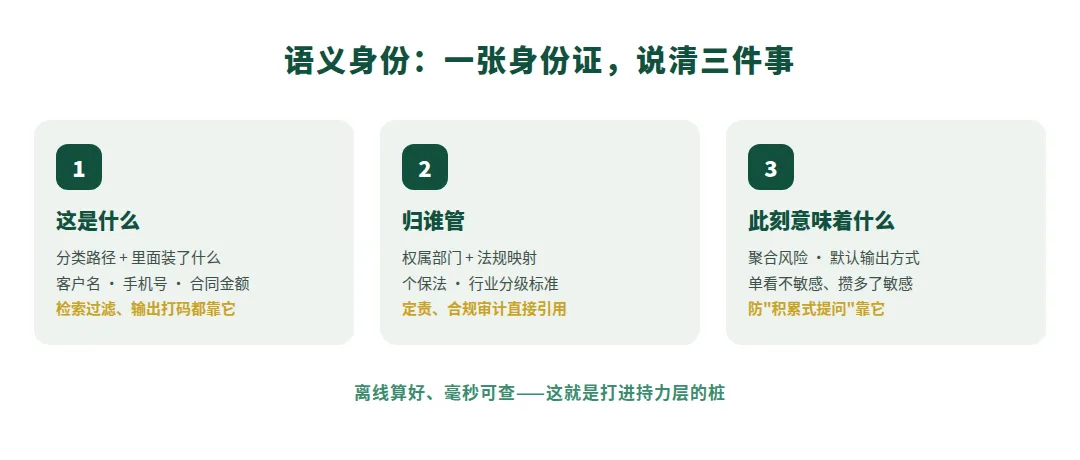
上篇讲过,AI 时代数据的敏感等级不再是固定的——同一个数字,在不同的任务、不同的组合里,敏感程度完全不同。所以过去那种”给文件贴个密级标签就完事”的做法不够用了。标签必须升级成语义身份:机器随时可查、毫秒内能读懂的一份结构化档案。
它至少要说清三件事:这是什么——不只是”敏感”两个字,而是具体的分类路径和里面装了什么(客户名?手机号?合同金额?);归谁管——业务上属于哪个部门,法规上对应哪一条;在什么情况下意味着什么——单看不敏感、攒多了敏感的数据,要标出”聚合风险”,默认输出该不该打码,也要提前写好。
说到这里还是抽象。来看主角登场:《华东区机构客户清单.xlsx》进入企业知识库的那一刻,它被切成若干小段,每一段都带着这样一张 JSON 格式的身份证:
{
“chunk_id”: “doc_7f3a92#p12”,
“source”: “华东区机构客户清单.xlsx”,
“content”: “华夏机械(集团)… 联系人:王某 138****2211 … 上年度合同额:3,700万”,
“semantic_identity”: {
“category_path”: “交易/投资者管理/投资者基本信息/机构投资者基本信息”,
“sensitivity_level”: “L3”,
“entities”: [
{“type”: “customer_name”, “count”: 1},
{“type”: “phone_cn”, “count”: 1},
{“type”: “contract_amount”, “count”: 1}
],
“owner”: “财富管理部”,
“regulation_map”: [“个保法-敏感个人信息”, “JR/T 0197-C3”],
“context_rules”: {“aggregation_risk”: “high”, “default_output”: “masked”}
},
“lineage”: {“derived_from”: null, “classifier_version”: “v2.3”, “ingested_at”: “2026-07-15”}
}
逐个字段翻译成大白话——注意每一项后面括号里写的”将来谁会用它”,这正是”桩”承重的地方:category_path 是分类路径,说明这段数据在企业数据目录里的位置(后面发权限时按它圈范围);sensitivity_level 是安全级别 L3(后面检索时按它过滤);entities 说明这一段里有一个客户名、一个手机号、一个合同金额(后面输出打码时按它定位);owner 是权属部门(出事时找谁定责);regulation_map 把它挂到具体法条和行业标准上(合规审计时直接引用);context_rules 里写着”聚合风险高、默认输出要打码”(后面防”积累式提问”靠它)。最后的 lineage 是族谱的起点——这段数据是原始数据,还没有衍生记录。
**为什么打桩必须是第一道工序?**因为后面每一道工序的每一次判断,都要在毫秒之间调取这张身份证。桩没打,后面的浇筑就是在旧假设上抹水泥。
三、插一个所有人都会问的问题:毫秒级,怎么可能?
读到这里,懂行的读者一定会拍桌子:让 AI 理解一段数据的含义,动辄几百毫秒甚至几秒,你说每次使用都要判一遍,还要毫秒级——怎么可能?
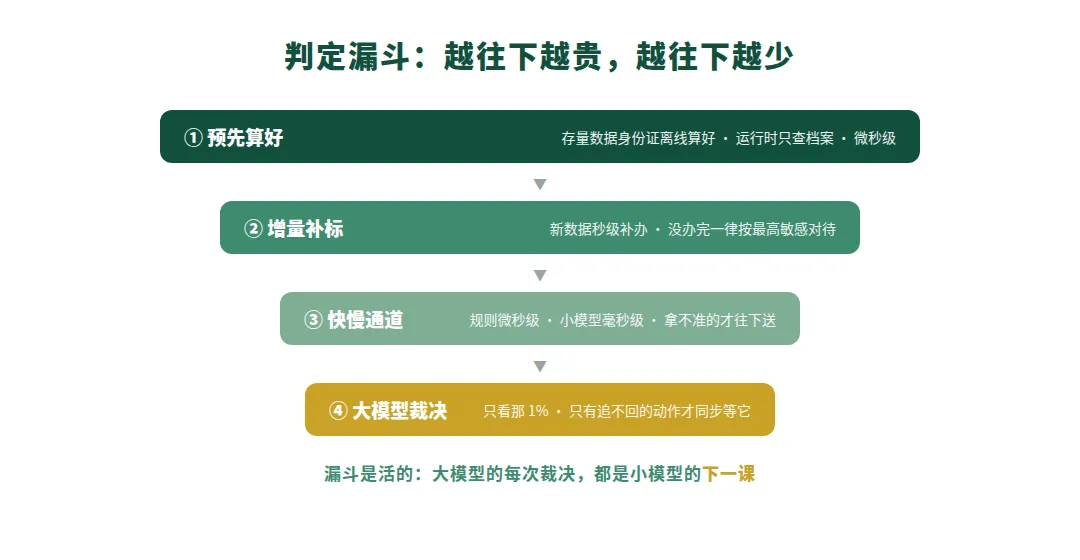
质疑完全成立,答案是一句话:**毫秒级判定 ≠ 毫秒级理解。理解是提前做完的,运行时只做”查身份证”这个动作。**具体是一个四层的”判定漏斗”,越往下越贵、越往下流量越少:
**第一层,预先算好。**存量数据的身份证(就是上面那张 JSON)在入库时已经离线算好、存进可以极速查询的库里。运行时的判定,本质是一次”拿号查档案”,微秒到毫秒级。
**第二层,增量补标。**新数据源源不断进来,靠事件触发的方式秒级补办身份证。补办完成之前怎么办?一律按最高敏感对待——宁可先拦后放,绝不裸奔。
第三层,快慢通道。真正没有身份证可查的,只有用户现敲的问题和 AI 现生成的回答。这部分走三级检查:格式明确的(证件号、卡号、密钥)用规则秒杀,微秒级;语义层面的判断交给专门训练的小模型,毫秒级;只有”可疑但拿不准”的极少数,才送大模型仔细裁决——而且只有外发、写记忆这类追不回来的动作,才值得停下来等裁决结果。
**第四层,族谱继承。**摘要、改写、统计值这些衍生数据,直接继承源头的身份证,不重新判。
**漏斗的要义是:99% 的流量停在便宜的前两级,大模型只看那 1%。**而且这个漏斗是活的——大模型每一次裁决的结果,都会变成小模型下一轮的训练材料,昂贵的那一层流量占比会逐月下降。
四、工序二 · 浇筑:给任务发权限,给数据上门禁
桩打好了,第二道工序是浇筑承台——把”给人发权限”升级成”给任务发权限”。
回到我们的故事。市场部的张伟对企业 AI 助手说了一句再平常不过的话:
“帮我整理一下华东区机构客户的季度服务情况,做份汇报。”
在面向过去的安全体系里,接下来发生的事只取决于一个问题:张伟有没有权限访问客户数据。有,就全放行;没有,就全拦住。
在施工图里,这一刻发生的是另一件事:系统为这一次任务签发了一张授权票据——
{
“task_id”: “t-20260728-0917”,
“principal”: “zhang.wei@bank.cn(市场部)”,
“goal”: “生成华东区机构客户季度服务汇报(内部使用)”,
“expires_in”: “2h”,
“data_scope”: {
“categories”: [“投资者基本信息/*”],
“max_level”: “L2”,
“L3_handling”: “仅聚合值,禁止明细”
},
“tools_allowed”: [“kb.search”, “doc.generate”],
“tools_denied”: [“email.send_external”, “memory.write_longterm”],
“output”: {“audience”: “internal”, “precision”: “aggregated”}
}
翻译过来:谁委托的(张伟)、要干什么(内部汇报)、有效期多久(两小时,过期作废)、能用哪些数据(客户基本信息类,最高到 L2 级;L3 只能看汇总数字,不能看明细)、能用哪些工具(查知识库、生成文档可以;对外发邮件、写入长期记忆不行)、结果给谁看(内部,且只能是聚合口径)。
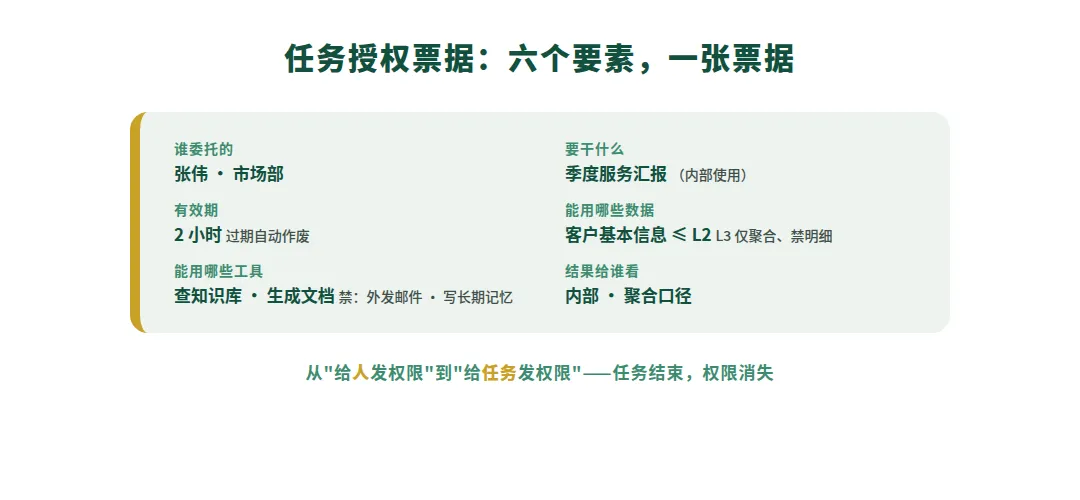
然后是全文最关键的一幕:AI 去知识库检索资料(也就是 RAG,让 AI 先查资料再回答)的那一刻,两张 JSON 相撞了。
检索引擎拿着票据里的 max_level: “L2”,去比对每个数据切片身份证上的 sensitivity_level。我们的主角——那个标着 L3 的切片 p12(华夏机械的手机号和合同额)——在候选名单阶段就被筛掉了,根本没有机会进入 AI 的视野。但票据写着”L3 允许聚合值”,所以提前算好的部门级汇总统计(L2)顺利放行。
所谓”判定”,就是这样一次字段对字段的比对。这也再次解释了毫秒级从哪来:两张提前写好的 JSON 打个照面,不需要任何”现场理解”。
最终张伟拿到的汇报是:“华东区机构客户 214 户,季度合同总额 4.2 亿,服务达标率 96%……”——任务完成了,汇报完整可用,而任何一个客户的名称、手机号、合同明细,一条都没有出现。
这就是”管用途”和”拦内容”的区别:不是把敏感数据拦在 AI 门外让业务残废,而是让每份数据只在被授权的用途里出现。
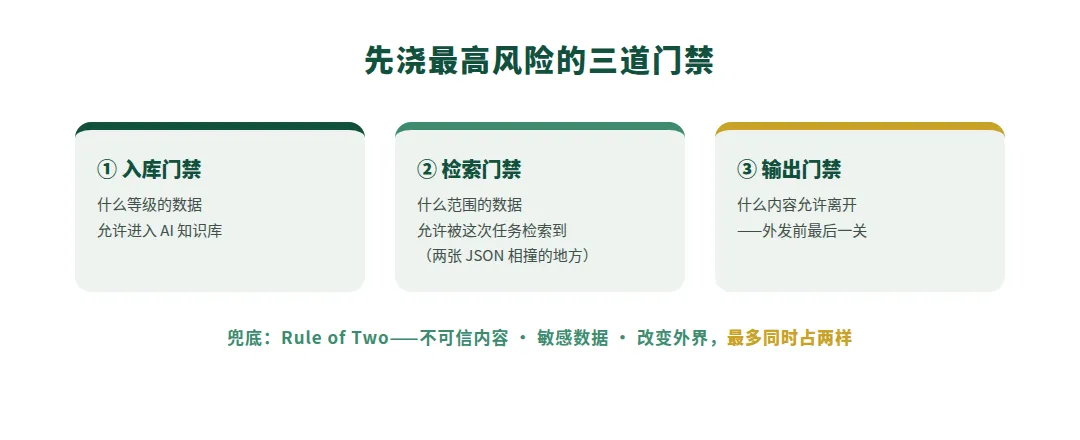
浇筑还有最后一层保险:Rule of Two 规则(Meta 提出的 Agent 安全实践)。一个 Agent 会话里有三件危险的事——读不可信的外部内容、接触敏感数据、执行改变外部世界的动作——三样最多同时占两样。假设张伟的这个会话中途还让 AI 读了一封外部邮件,“不可信内容”和”敏感数据”已经占了两样,那么对外发送类的工具在本会话直接禁用。就算前面的防线全部失守,数据也出不去。
五、工序三 · 起结构:给数据修族谱
桩和承台之上,第三道工序是起结构——立两根”血缘梁”,铺一层”控制平面”。
血缘,说白了就是数据的族谱:每一个输出,都记下它的来龙去脉——用了哪些数据、经过哪个模型、哪个 Agent 做的决定、哪些是原始事实、哪些是 AI 的推断。
族谱有什么用?故事继续往下走。张伟的汇报生成之后,文档里每个段落都挂着一条看不见的引用链:
汇报#第3节 ← 聚合统计值 ← [chunk#p12 (L3), chunk#p13 (L3), …]
三天后,有位同事觉得这份汇报写得不错,想转发给外部渠道伙伴。在”外部发送”这个关口,系统查了一眼族谱:这份看起来”干净”的内部汇报,上游有 L3 明细数据——按标签体系的规则,要么脱敏后再发,要么走审批。如果没有族谱,这份汇报就直接出去了,而它的每一个数字背后都是高敏感明细。
族谱还有一个更隐蔽的用途:数积累。上篇说过,AI 时代的泄露方式是”问”——一百个单独无害的小问题,拼出一份完整的客户名单。单看每一次都合规,靠什么发现?靠族谱计数:系统注意到,市场部本周对同类客户数据的聚合查询已经是第 47 次,触发了聚合风险复核。单次全合法、累计成风险——只有族谱看得见这种事。
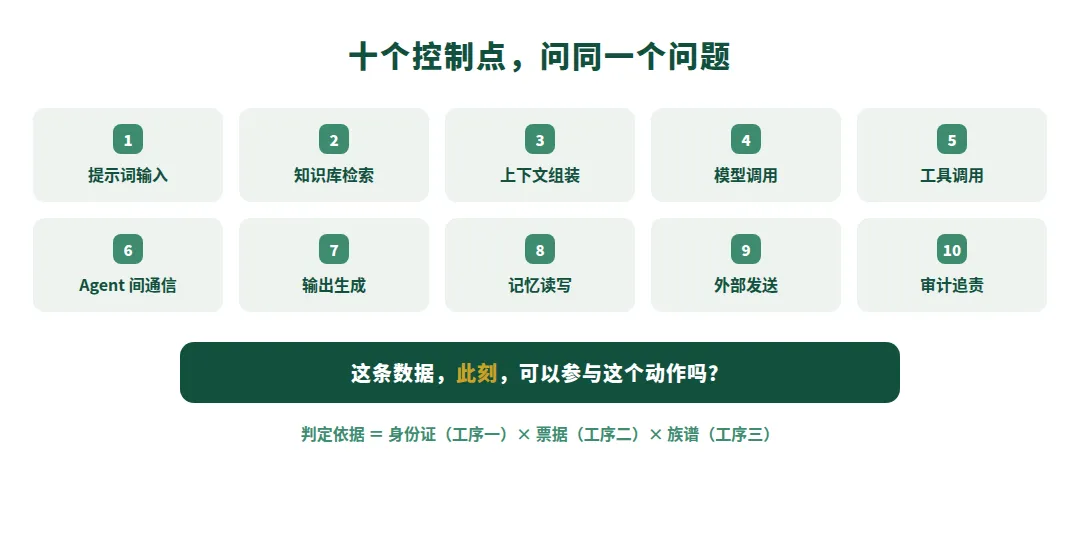
族谱之上,是控制平面:在 AI 链路的十个关键位置(提示词输入、知识库检索、上下文组装、模型调用、工具调用、Agent 之间通信、输出生成、记忆读写、外部发送、审计追责)各设一个检查点,每个检查点都问同一个问题:这条数据,此刻,可以参与这个动作吗?
判断的依据从哪来?三样东西:身份证(工序一)× 票据(工序二)× 族谱(工序三)。控制平面自己不需要”理解”任何数据——它只是个尽职的查证员。这也是为什么说前两道工序是它的承重:没有身份证和票据,十个检查点全部无据可查。
MITRE 今年公布的一起 Agent 安全事件调查里,最让人后怕的不是泄露本身,而是事后连”这个 Agent 为什么这么做”都还原不出来。没有族谱的 Agent,出了事连案发现场都找不到。
六、工序四 · 验收:三个数字,九十天
最后一道工序:验收。而且这个验收和大楼竣工不一样——它不是一次性的,是持续的。
监控思路也要换。过去看”这个账号的行为像不像它的历史”(行为基线),但 Agent 的正常行为本来就像攻击:一秒读几百份文件、24 小时不睡觉。所以要换成问”这串行为还在不在为最初授权的那个目标服务”(目标偏离检测)——张伟的汇报任务两小时后过期,票据同时作废,任何超出目标的动作立即失去依据。
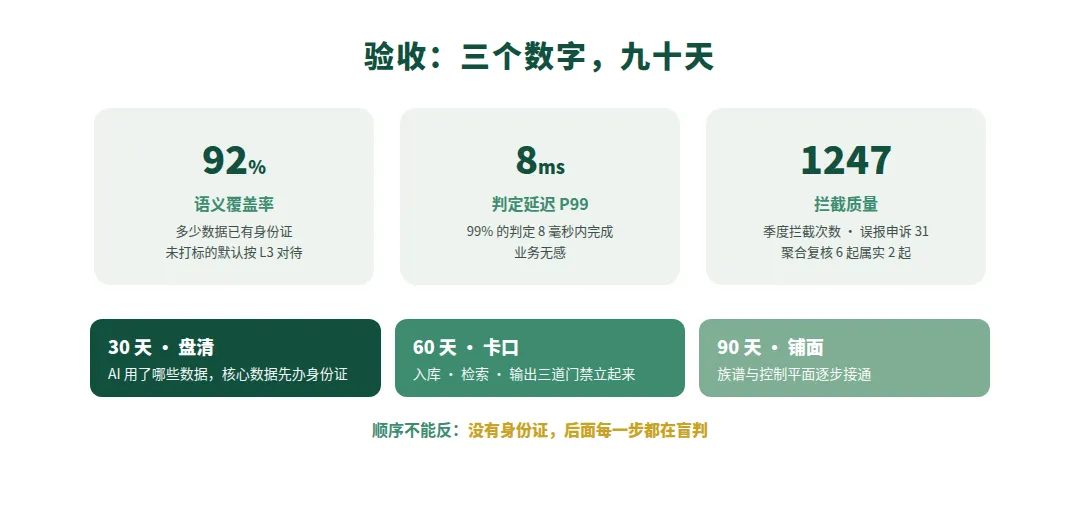
验收还要给安全负责人三个能写进汇报 PPT 的数字。还是用例子说话,一份季度验收报表大概长这样:语义覆盖率 92%——全部数据资产里,92% 已经有了身份证,剩下 8% 未打标的一律默认按 L3 对待;判定延迟 P99 = 8 毫秒——99% 的检索过滤判定在 8 毫秒内完成,业务无感;拦截质量——本季度拦截 1,247 次,其中误报申诉 31 起,聚合风险人工复核 6 起、确认属实 2 起。
落地节奏可以按”30/60/90 天”走:头 30 天盘清——AI 用了哪些数据,核心数据先办身份证;60 天卡口——先把风险最高的三道门禁立起来;90 天铺面——族谱和控制平面逐步接通。
**唯一不能做的,是把顺序倒过来。**没有工序一的身份证,后面每一步都是在盲判。
七、两个流行的错觉
施工图讲完了。落地之前,还要替读者挡开市场上两个流行的错觉。
错觉一:“网关式内容过滤,加个 AI 引擎,就是面向未来的安全。”
这类方案把检测点从出口挪到了模型入口,再配一个语义检测引擎,看起来覆盖了 AI 场景。但检测点挪了,问的还是老问题——“这段内容里有没有敏感信息”。它拦得住写出来的秘密,拦不住组合、积累和动态等级,防的还是”偷”,只是把岗哨往里挪了一步;流量上现场判出来的”等级”,背后没有资产侧的桩来托底,分级管控的”级”是悬空的;而且它卡的是内容、不是用途——同样是张伟那个汇报任务,内容过滤给他的是一份被挖掉敏感信息的残缺汇报,任务授权给他的是完整可用的聚合汇报,且明细一条没漏。
分辨起来只需三问:它的”敏感”是现场猜的,还是资产上提前算好的?它拦的是内容,还是用途?一百个不敏感的小问题拼成的泄露,它在第几个报警?答不上来的,是在旧范式上刷漆。
错觉二:“DSPM 就是施工图。”
DSPM(数据安全态势管理)是一张地图:数据在哪、暴露面多大。施工图交付的是红绿灯:此刻这一次使用,放行还是拦截。地图不能代替红绿灯,红绿灯也离不开地图——两者是配合关系,不是替代关系。
八、结语:让每一段数据,都自带身份证
最后,把四道工序倒过来看一遍,你会发现一件事。
数据分类分级,过去总被当成”把门”工具里的一个配置项——扫一遍、贴个标、出份报告,然后锁进抽屉。但走完这张施工图会发现,它真正的位置是嵌入整个 AI 业务的全流程:入库时,它是那张 JSON 身份证;授权时,它是票据里的数据范围;检索时,它是过滤条件;族谱里,它是每个节点的锚点;验收时,它是覆盖率指标。
张伟那份汇报能做到又完整、又安全,靠的不是门口某台检测器,而是那张从入库第一天起就跟着数据走的身份证。
**让每一段数据都自带身份证,才能真正解决 Agent 模式下的数据安全问题。**这也是我们做 AiDClass 的起点——把分类分级这一根桩打深、打实。桩之上的整张施工图,需要整个行业一起来盖。
面向过去的安全,守住昨天已经理解的风险;面向未来的安全,从今天的第一根桩开始。
(十个控制点,每一个都值得单独展开一篇。下期见。)
参考资料
[1] Gartner,AI Trust, Risk and Security Management(AI TRiSM)框架;业界关于其运行时执行缺口的分析(2026)
[2] NIST,Accelerating the Adoption of Software and AI Agent Identity and Authorization(Concept Paper,2026.2)
[3] Meta AI,Agents Rule of Two: A Practical Approach to AI Agent Security(2025.11)
[4] MITRE ATLAS,OpenClaw Investigation(2026.2)
[5] NIST CSRC,Zero Trust Architecture(持续验证)
[6] 前篇:《你在做的安全,是面向过去的安全,还是面向未来的安全?》
说明:文中案例为示意场景,JSON 结构为简化示例;具体企业环境请以实际评估为准。
—— 模界数智
相关解决方案
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流