AI 数据安全落地现状:五家国际厂商各盖了哪一段
本文原载于微信公众号,原题《施工图画完了,有施工队干活了,宜居否?》。
上一篇的施工图发出后,被问得最多的是同一件事:说得好听,怎么落地?
这一篇不讲道理,只看工地现场——已经有人开工了,甚至完成了施工图。看完你会发现:图纸空着的地方,恰恰要从“中文的第一根”桩补起。
一、被问得最多的,是同一个问题
《面向未来的安全,从哪一根桩打起?》发出后,后台和评论区的追问一个比一个内行:
“数据切分打标,怎么保证每一段都不偏不漏?”
“明细不可用、聚合可用——谁来聚合?怎么聚合?”
“张伟授权给子 Agent 读数据,传到下一个子 Agent(Sub Agent*)* 还算数吗?**”
“整个过程没有一个系统性框架,开发的时候怎么检查?基本很难落地吧。”
**先说态度:**这些问题问得对!
**再说****观点:**上一篇给的是施工图——先干什么、后干什么;施工图下面还有一层施工工艺——每一步具体怎么干。工艺不讲清楚,图纸就还是张纸。
这一篇换个角度,直接看工地!——过去两年,国际上的安全厂商已经照着几乎相同的图纸开工了。有人盖了这一段,有人盖了那一段,有一家甚至把一条线从头走到了尾。看完三件事就清楚了:这套思路不是空想;每一步都有真实的产品在收钱;以及,还空着的那几段是什么。
二、先看全景:谁干了哪一段
把国际上叫得上名字的几家厂商,放到四道工序里(打桩→浇筑→起结构→验收)上比一比:
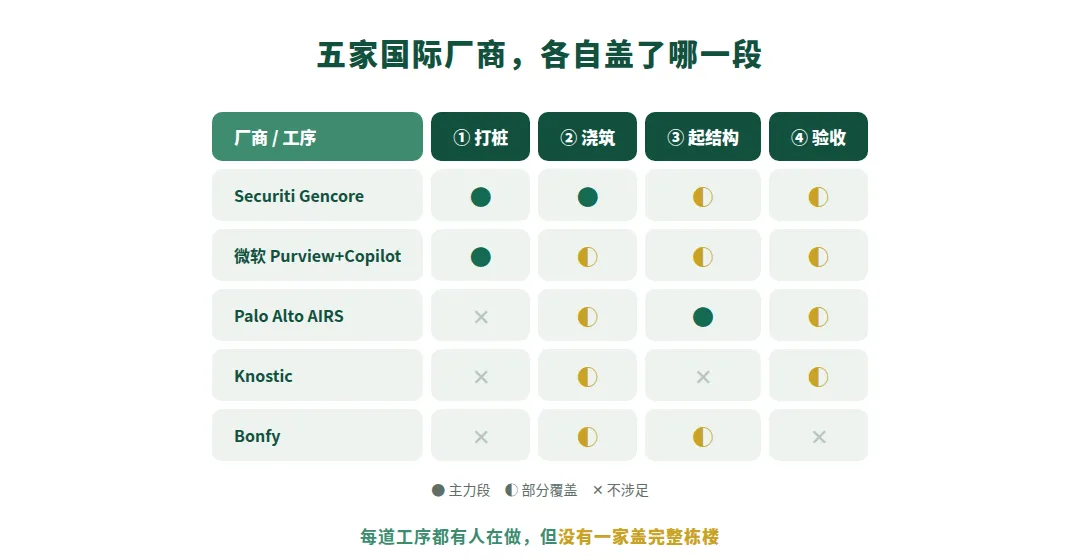
一眼能看出两件事。
每一道工序都有人在做;
没有一家盖完了整栋楼。
其中干活能力最强的,来自美国公司 Securiti。值得把它单独讲透,因为它做的事,几乎就是上一篇文章的”英文版”。
三、有人把这条路走通了:张伟的故事,换个产品重演一遍**!**
还记得张伟吗?市场部员工,让 AI 助手整理客户情况做汇报,背后是那份高敏感的《华东区机构客户清单.xlsx》。现在把这个故事放到 Securiti 的产品(叫 Gencore AI)里重演一遍——注意每一步和上一篇的对应关系:
**第一步,数据进门先领身份证。**客户清单接入时,系统自动识别内容、自动分类打标——什么类别、什么级别、归谁管、对应哪条法规,全写在标签里。这就是”打桩”:理解数据这件事,在入库时就做完了,不等到用的时候现场猜。
第二步,进门时顺手**-规整一下。**接入管道上直接执行企业规矩:该脱敏的脱敏、该删的删、重复的去掉。对应上一篇的第一道门禁——语料入库门禁。
第三步,权限跟着数据一起进 AI **的资料库。**这是最硬核的一步:数据变成 AI 可检索的资料(向量)时,“谁能看这份数据”的信息跟着一起装进去。张伟发布任务并检索时,系统按他的权限和数据的标签过滤——超出范围的内容,压根不会出现在候选名单里。上一篇说的”两张 JSON 相撞”,在这里不是比喻,是产品功能。
**第四步,三道防火墙合围。*它的防线明确分三个位置:输入端(拦提示词注入、去掉输入里的敏感信息)、检索端(就是第三步)、输出端(拦住往外走的敏感内容)。对照上一篇——我们写的三道门禁是:入库、检索、输出。*一家没见过这篇文章的美国公司,给出了几乎相同的划分。这不是巧合。同一张图纸,谁认真推导,都会推出同一个结论。
第五步,族谱全程可查**。**哪个文件、变成了哪些资料、装进了哪个库、被哪个 AI 用过——一张关系图全程记录。张伟的汇报要外发?有没有高敏感明细,图里查得到。
**第六步,态势报表。**覆盖了多少数据、拦了多少次,仪表盘上有数——对应上一篇的”验收”。
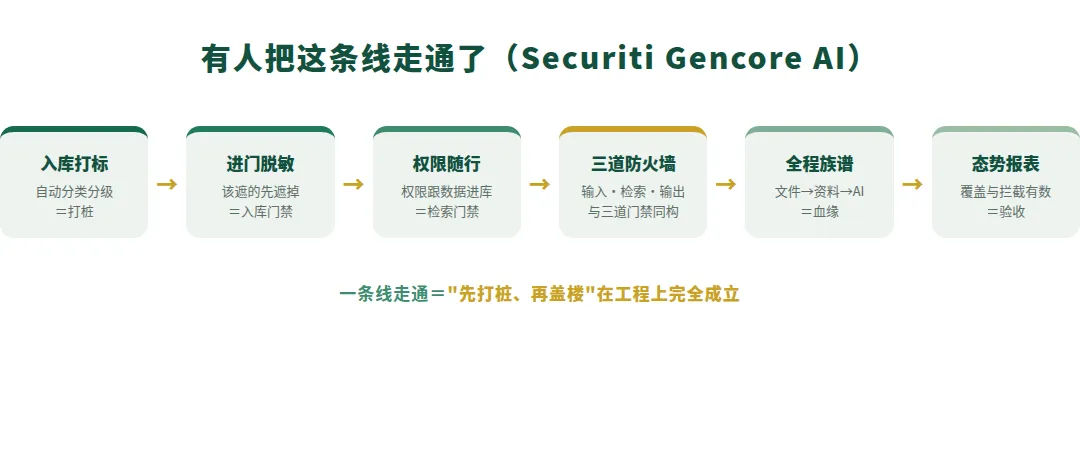
一条路走通,证明了一件事:**“**先打桩、再盖楼”在工程上完全成立,而且已经商业化。当然它也有没做到的——先按下不表,第六节专门讲。
四、其他几家,各盖了一段**——顺便识别****三个问题**
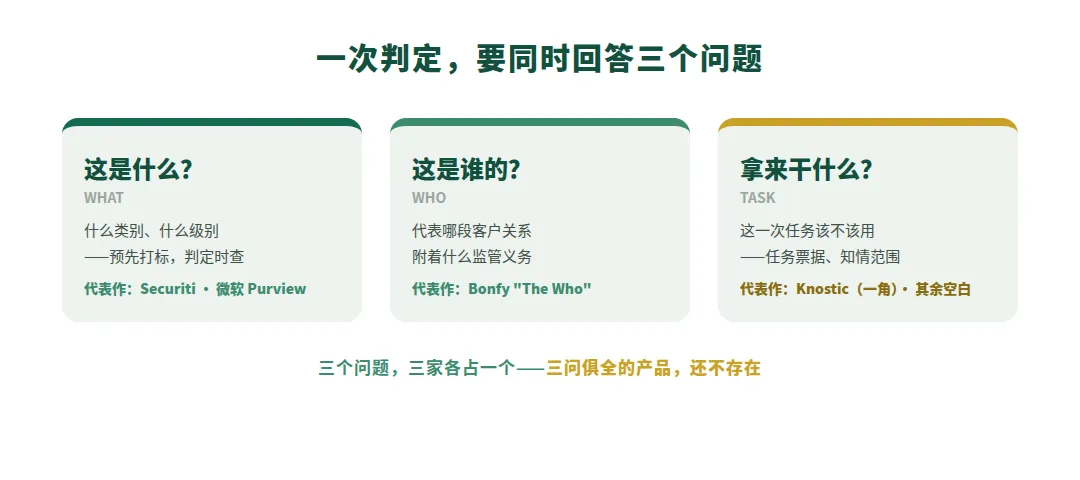
判定”这次能不能用这份数据”,其实要同时回答三个问题:
这是什么?(什么类别、什么级别)——微软的做法最有代表性:给文档打敏感度标签,标签跟着文件走;带某些标签的内容,AI 助手(Copilot)根本不去碰;更妙的是,AI 生成的新文档,自动继承来源里最高等级的标签——衍生数据不裸奔,正是上一篇”族谱继承”的产品化。微软还给每个 AI Agent 发了独立工牌(Entra Agent ID):Agent有自己的身份、自己的权限清单、能用哪些工具一一绑定。
这是谁的?(代表哪段客户关系、附着什么义务)——Bonfy 公司把这个问题做成了招牌,概念就叫 “The Who”。它的观点很锋利:两份文档标签相同,但一份关于普通客户、一份关于受严格监管的客户关系,风险完全不同——所以它用一张不断学习的关系图,实时判断”这份数据背后是谁、带着什么义务”。这话其实在替上一篇的”敏感等级是运行时函数”作证:等级从来不是贴死的,要看数据背后站着谁。
拿来干什么?(这一次任务,该不该用)——Knostic 专做这一部分:同一个问题,CFO 问和实习生问,AI 给的答案深度不同——不看”内容敏感不敏感”,看”这个人该不该知道”。这就是上一篇”资源授权 ≠ 用途授权”最纯粹的实现。
是什么、是谁的、干什么用——三个问题,三家各占一个。而“巡逻队”也有人做了:Palo Alto(全球最大的安全公司之一)的 Prisma AIRS 专管运行时Agent 调用了什么工具、连了什么外部服务、Agent 之间说了什么,实时盯着,越权就拦。它不打桩,但把上一篇十个控制点里最难的几个(工具调用、外部连接、Agent 通信)做成了产品。
五、老门禁卡,刷不开新大楼
还有一个读者的问题值得单独回答:“张伟授权给子 Agent,传到下一层还算数吗?”
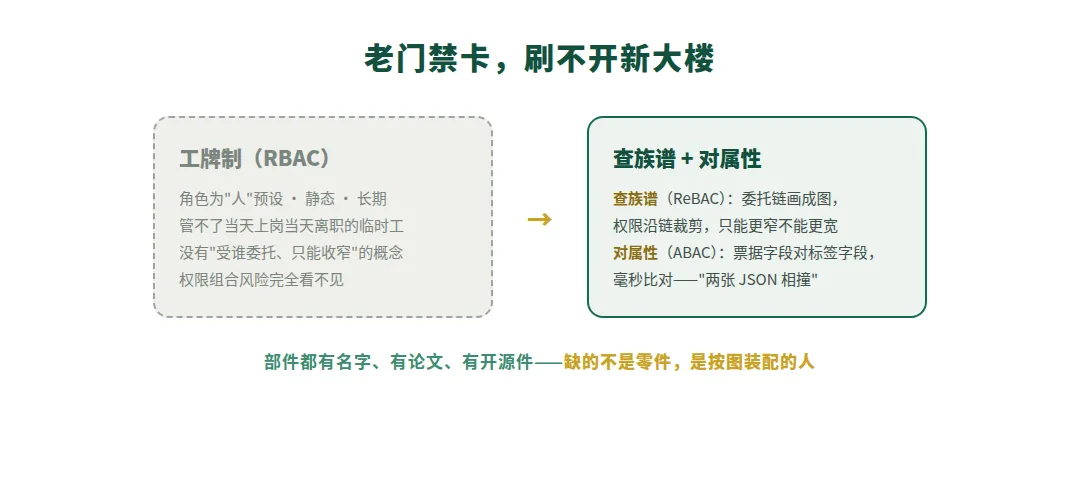
这个问题的根子在授权模型上。过去几十年,企业用的是”工牌制”(行话叫 RBAC):给每个人预设一个角色——你是客户经理,你能进这几个门。工牌制的前提是:人是长期的、角色是稳定的、数量是有限的。
Agent 把三个前提全打破了:它是临时的(一个任务活两小时)、动态的(干着干着自己派生出子 Agent)、海量的(一天成千上万个)。给每个只干两小时活的临时工提前办工牌,办不过来,也没意义。更要命的是,工牌制里根本没有”受谁委托、代表谁办事、权限只能收窄不能放大”这些概念——上一篇假设四、假设五的失效,追到根上就是工牌制到头了。
今天真正能落地的是两件套,说白了就是查族谱 + 对属性:
查族谱(行话 ReBAC):把”张伟 →委托→ 汇报任务 →派生→ 检索子任务 →调用→ 检索工具 →触碰→ 客户数据”这条委托链画成一张关系图,判权限就是沿着图查这条链通不通。子 Agent 的权限不是继承张伟的工牌,而是从父任务裁剪出来的一小份——只能更小,不能更大。传到第二层、第三层,每一层都在图里,每一层都只会更窄。
对属性(行话 ABAC):任务票据上写着”最高只能用到 L2”,数据身份证上写着”我是 L3”——两个属性一比对,放行还是拦截,结果秒出。上一篇”两张 JSON 相撞”的画面,就是这个模型,规则引擎(Cedar、OPA)都是现成的开源件。
族谱管**“谁可以代表谁”,属性管”这份数据此刻能不能用”**——两件套装在任务票据里随身携带。所以”没有系统性框架”这个印象要修正一下:框架不但有,而且每个部件都有名字、有论文、有开源实现。缺的从来不是理论和零件,是把它们按图纸装配起来的人。
六、实话实说:还有四段没人盖
把各家的楼拼起来,空着的部分也就清楚了。四件事,全世界都还没做完:
任务级的**“临时票据”****。**各家授权还是基于”人”的长期权限,没有”为这一次任务签发、两小时后自动作废”的票据机制——上一篇写的授权票据,仍然领先于现有产品。
聚合的自动化。“明细不可用、聚合可用”里的聚合视图,今天仍靠数据团队手工预建。谁来聚合、聚合到什么粒度才安全,还是人的活。
**积累式泄露的检测。**一百个不敏感的小问题拼出一份客户名单——“第 47 次触发复核”这种累计监测,目前没有一家做成产品。
**中文的桩。**以上所有产品的分类器认的是 GDPR、HIPAA;个保法、数据安全法、金融行业分级目录的体系,中文合同、工单、客服记录里的敏感信息长什么样——这一层,国际产品不做,也做不了。
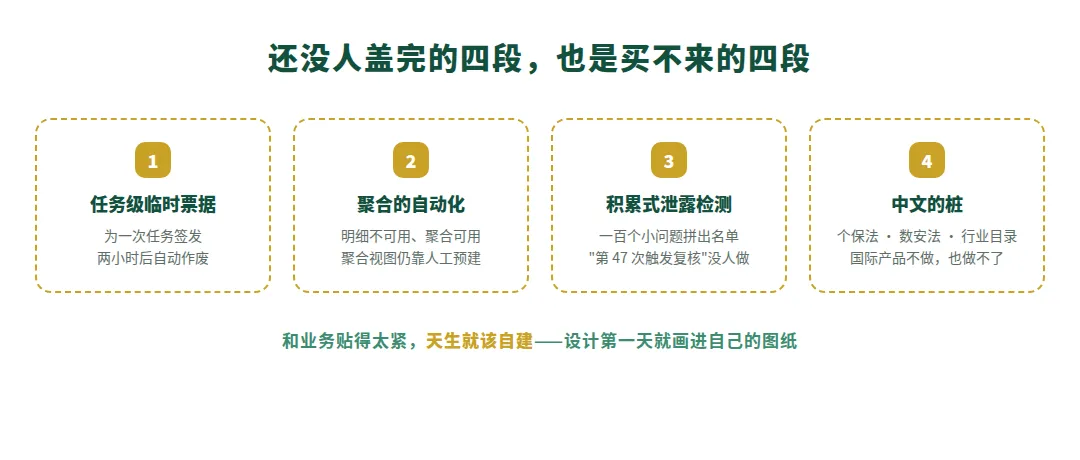
为什么恰恰是这四段没人盖?仔细看会发现一个共同点:它们和业务贴得太紧,本来就不是外部厂商能替你做完的。任务票据里写什么——任务怎么定义、有效期多长、哪些工具算高危——只有你的业务流程知道;聚合到什么粒度算安全、什么口径能给谁看,是业务语义,业务和数据团队之外没人能拍板;积累到多少次算异常,阈值来自你们自己岗位的正常行为分布;中文的桩,更是要贴着你的行业目录和业务行话打。
换句话说,这四段不是”市场还没供货”,而是”天生就该自建”——它们本质上是桩在业务侧的延伸,必须在设计 AI 应用的第一天,就画进自己的图纸里。指望日后买一个外挂补上,和指望楼盖完了再打桩,是同一种错觉。
这也把整个系列的话说圆了。上一篇开头写:“安全买不来,只能建。“现在可以补上后半句:能买的部分,全世界已经在卖**——打标引擎、防火墙、控制平面,都是好材料;买不来的部分,才是你自己的工程——****任务怎么授权、聚合怎么定、积累怎么算、你的数据怎么说中文。**空白不是”不可行”的证据,是图纸上标给你自己的那几段施工段。
七、结语:全世界都在盖,中文这根桩得自己打
回到开头那些追问。怎么落地?现在可以这样回答——
打桩,有人做了;入库、检索、输出三道门禁,有人做了,而且划分和我们一模一样;权限跟着数据走,有人做了;族谱,有人做了;Agent 的独立工牌,有人做了;查族谱加对属性的授权两件套,论文和开源件都是现成的。**“安全买不来,只能建”****——但”建”****不是从零发明,全世界已经把大半张图纸变成了钢筋水泥。**剩下的那几段——票据、聚合、积累、中文的桩——买不来,要在设计你自己的 AI 系统时,从第一天就长在里面。
真正需要从头打的,是中文世界的那根桩:让中国企业的每一段数据——按中国的法规目录、行业标准、业务语言——自带一张身份证。这根桩,国际厂商打不了,只能我们自己打。这也是我们做 AiDClass 一直在干的事:先把中文的第一根桩,打进持力层。
面向未来的安全,全世界已经开工。我们没有落后,只是分到了自己该修的那一段。
参考资料
[1] Securiti,Gencore AI 与 Context-aware LLM Firewalls(产品文档)
[2] Microsoft Learn,Microsoft 365 Copilot 数据保护架构;Purview 敏感度标签与 Copilot(2026)
[3] Microsoft Security Blog,Least Privilege for AI Agents: Identity, Access, and Tool Binding(2026.7);Entra Agent ID
[4] Palo Alto Networks,Prisma AIRS 3.0(2026.3)
[5] Bonfy.AI,“The Who” Is No Longer a Metadata Problem, It’s an Enforcement Problem
[6] Knostic,The GenAI Knowledge Security Platform
[7] Google,Zanzibar: Google’s Consistent, Global Authorization System;开源实现 OpenFGA / SpiceDB
[8] 前篇:《你在做的安全,是面向过去的安全,还是面向未来的安全?》《面向未来的安全,从哪一根桩打起?》
说明:文中对各厂商能力的描述基于其公开资料,细节以厂商官方文档为准;产品对比仅为架构路线讨论,不构成选型建议。
—— 模界数智
相关解决方案
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流