企业为什么不敢放开用大模型:数据安全治理恐惧与四条破解路线
本文原载于微信公众号,原题《拆掉企业Token 采购最大的障碍——数据安全治理恐惧》。
大模型卖得动,先得让决策层放心。围绕这道闸门,OpenAI 在开放、Google 在圈地、中国选了第三条路——这是一场看不见的生态战。
一、AI 卖不动,卡点常常不在模型,在“决策层没底”
把一线企业采购大模型的过程拉开看,你会发现一个反直觉的事实:真正卡住 token 消耗规模化的,往往不是模型能力,而是决策层心里没底。
这里要先纠正一个常见的误解。在国内,决定要不要放开用 AI,通常并不是安全团队说了算——安全团队的话语权其实没那么大。真正按下暂停键的,是领导的顾虑:行业监管越来越严,万一员工把敏感数据灌进去、万一出了合规事故,责任算谁的?在这种不确定面前,很多企业宁可缩手缩脚,也不敢贸然铺开。
而这背后还有一层更扎心的原因:很多时候,是安全团队没能给领导足够的信心。 业务部门兴冲冲想全员用上 Claude、ChatGPT 或国产大模型,IT 也接好了 API,但当领导问出那一组问题——员工灌了什么敏感数据?出了事能不能审计、能不能溯源?数据会不会被拿去训练、会不会出境?现有的 DLP、SIEM、留存策略管不管得住这个新入口?——如果安全团队答不利索、拿不出一套可看、可控、可交代的方案,领导自然不敢点头。
这些问题没有让人放心的答案之前,企业版席位铺不开,token 消耗自然上不去。模型厂商卖的是能力,但能不能放开用,取决于决策层有没有信心——而这份信心,往往正是安全团队没能给够的。
于是 2026 年出现了一个耐人寻味的现象:Anthropic 一口气拉来 28 家安全厂商,把 Claude 的活动日志接进它们的产品里——CrowdStrike、Varonis、Netskope、Microsoft Purview、Forcepoint、Zscaler……几乎覆盖了企业安全栈的所有品类。海外媒体一句话点破:“Everyone suddenly wants Claude’s audit logs.”(所有人突然都想要 Claude 的审计日志。)
这不是巧合。模型厂商的一条隐形护城河,正在浮出水面:安全生态。
二、这套生态在解决什么:把”治理恐惧”翻译成可对接的管道
要看懂这场生态战,先得理解它的底层逻辑。
核心驱动力,就是拆掉前面那道”数据安全治理恐惧”。 模型厂商想解锁企业营收,就必须帮客户把这份顾虑变成信心:让决策层敢拍板、让安全团队拿得出可看、可控、可交代的方案。但 Anthropic、OpenAI 这类纯模型厂商自己不卖 DLP、不卖 SIEM,怎么办?答案是——开一个标准接口,把现成的安全生态请进来。
技术上,这套机制并不复杂。以 Claude Compliance API 为例,它对外暴露两类数据:一是会话内容(聊天、上传文件、project 内容、生成结果),二是活动事件日志(登录、管理员操作、配置变更)。第三方安全厂商把这些数据拉到自己的引擎里,套用它们既有的策略——DLP 分类规则、SIEM 关联、UEBA 行为分析、DSPM——再呈现在客户天天在看的那块仪表盘上。
这里有一个容易被忽略、却很关键的区分:这套合规 API 是”旁路拉取(pull)、事后审计”为主,不是”内联实时拦截(inline)”。 它回答的是”Claude 内部发生了什么”,而真正在网络层当场拦下敏感数据外发的,是 SASE 正向代理那条线。两者互补,而不是替代。
最终,这是一个三方共赢的结构:模型厂商解锁采购、安全厂商在 AI 时代保住相关性、客户用现成工具和策略管 AI,不必另起炉灶。
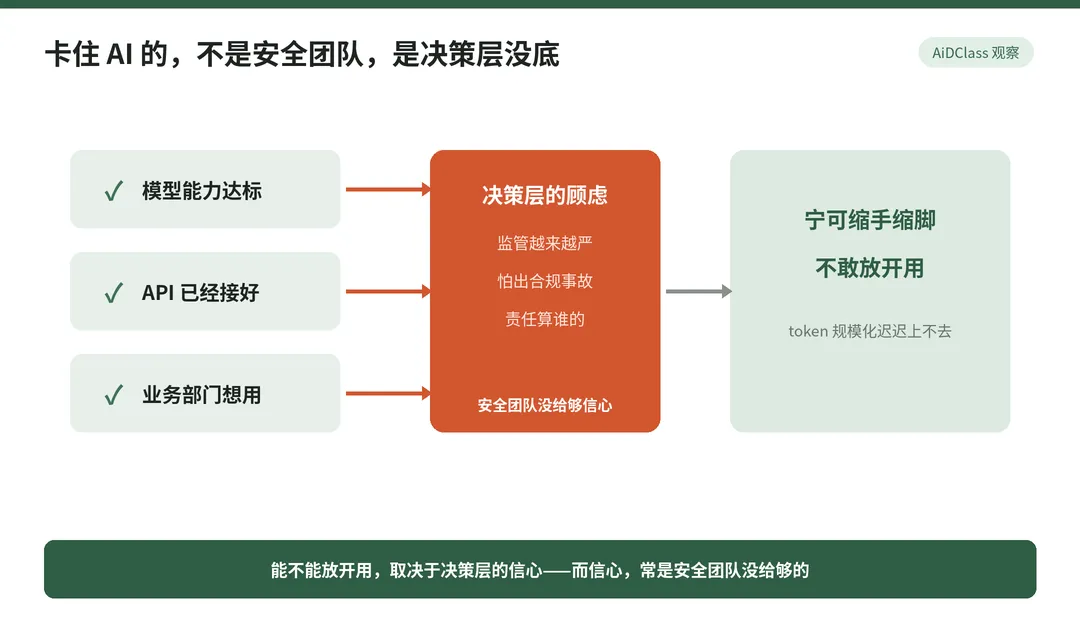
模型能力过关,却被”治理恐惧”挡在采购闸门外
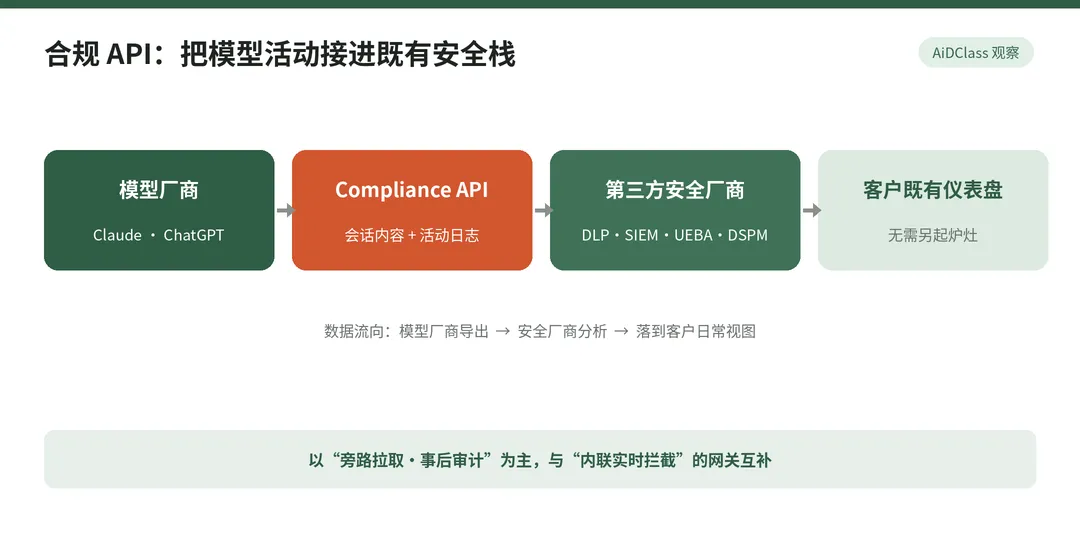
合规 API 如何把模型活动接进既有安全栈
三、海外两条路:开放派 vs 整合派
把海外头部厂商铺开看,会发现它们走了两条截然不同的路。
开放派——Anthropic 与 OpenAI。 它们是纯模型厂商,没有自己的云和安全产品,所以是”被迫开放”。
Anthropic 的 Compliance API 一次拉来 28 家集成,而且开放了”会话内容 + 活动事件”两层,覆盖最广。OpenAI 其实起步更早,它的 Compliance 平台设计得很见功力,给了两种访问模式:一种是不可变、append-only 的合规日志(Compliance Logs Platform),纯审计留存用;另一种是Stateful Compliance API,能按请求时点查询”某条消息此刻还在不在”,服务于按条删除与可证明的留存合规。两家是同一条赛道上的正面竞争。
整合派——Google。 Gemini 嵌在 Workspace 和 Google Cloud 里,直接继承 Google 自家的 DLP、数据驻留、审计日志、IAM,还加上 VPC Service Controls、CMEK,DLP 甚至通过 Chrome Enterprise Premium 管到浏览器里的复制粘贴。它不需要开放给一个外部生态,而是”用我自家云的安全栈,管我自家的 AI”。
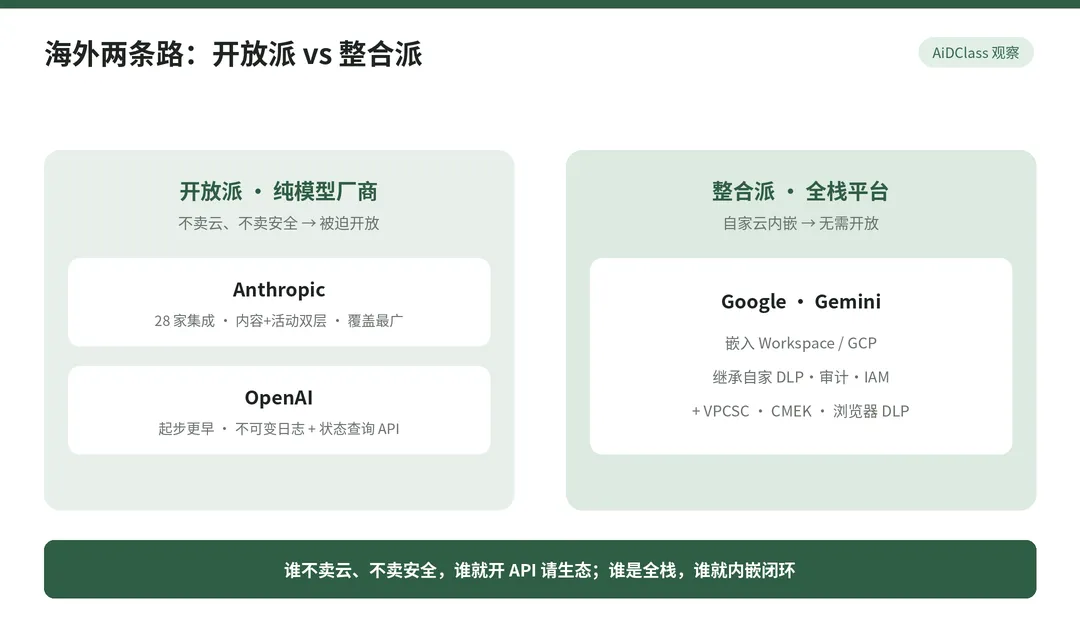
开放派与整合派,两种生态形态
四、回看国内:为什么没长出同样的生态
把同一把尺子放到国内,结论很清楚:国内还没有出现一个”模型厂商把合规做成开放 API、引第三方共建”的对等生态——不是没人做,而是结构上走了另一条路。
第一,结构差异。 国内做大模型的主力——阿里、字节、腾讯、百度——都是全栈玩家:模型、云、安全产品都在自己手里。阿里云百炼的审计、合规、数据出境检测,直接由阿里云日志服务(SLS)、WAF、云采用框架(CAF)的合规审计兜住;火山方舟绑字节、千帆绑百度。它们和 Google 一样,没有动力开放。
第二,安全厂商的切入点不同。 奇安信、深信服、安恒、绿盟、360、天融信这些综合厂商,做 AI 安全时走的是 AI 安全网关 / 大模型防火墙(inline) 这条路——“统一接入、统一管控、统一检测”,而不是拉取式的合规 API。为什么偏内联?因为国内私有化部署占比高,模型常常跑在客户自己机房里,天然的控制点就是前面架一道网关。
第三,中国特有的驱动力。 网信办的生成式 AI 管理办法、信通院的数据与可信治理标准、CNCERT 的大模型安全众测,把”合规可信”做成硬门槛;而数据出境 / 数据跨境这条强约束,是美国市场根本没有的。
于是国内留下了一个清晰的空白:缺一个”中立模型厂商 + 开放合规接口 + 第三方安全生态”的角色。 最有可能补位的,恰恰是那些不绑大云的中立玩家——智谱、Kim(月之暗面)、MiniMax、DeepSeek。因为它们的处境和 Anthropic 一样:自己没有全栈安全能力,开放反而是更优解。
值得盯的信号是:哪家国内中立大模型厂商先推出标准化的”合规 / 审计 API”,并拉一批安全厂商做首发集成——那会是国内版生态成形的起点。
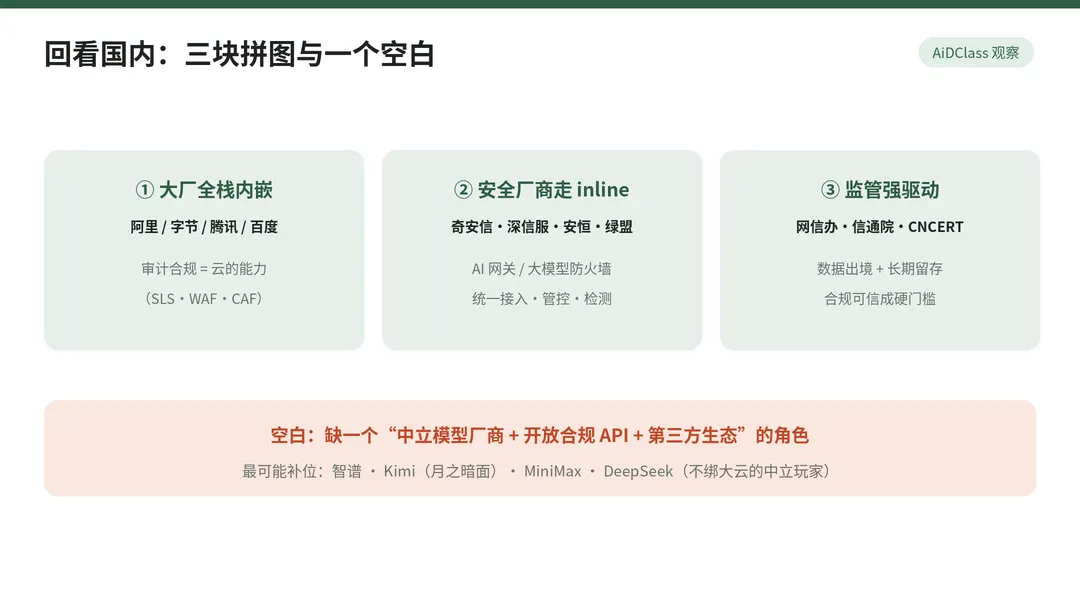
国内的三块拼图与一个空白
五、第三条路:全本地部署,自己当生态的”地主”
还有一种国外不是很普遍、却最契合国内现实的形态——完全本地部署。
如果你把 Qwen、Kimi、MiniMax 这类开源模型私有化部署在自己机房,那么你就不再依赖任何模型厂商的 API。控制点完全归你所有:在本地模型前面架一道自托管的 AI 网关 / 大模型防火墙,它就同时扮演了 Compliance API + DLP + 内容安全三个角色,而且数据一步不出域。
这套架构比云上的旁路拉取更强——它是内联的,能实时阻断、全量留存。前面提到 OpenAI 那两个能力,在自托管下也能自己实现:不可变 append-only 日志,靠 WORM 设备 / 国密哈希存证来兜底;状态查询,因为数据库在你手里,留存、删除、按时点查询都自己建。
可选的”零件”也很现成。开源一侧:Bifrost(明确提供不可变审计日志、气隙部署)、Portkey(2026 年 3 月整套网关开源,内置 PII 脱敏与越狱检测)、Kong AI Gateway、以及 LLM Guard、NeMo Guardrails 这类守护栏。国产商业一侧更是为私有化而生:安恒的大模型内容安全防火墙,深信服、启明星辰、绿盟等也都配套了安全大模型与 AI 网关。
但有两件事必须记住。第一,网关成了新的”皇冠明珠”,也就成了头号攻击目标。 上个月在野利用的 LiteLLM 链式 RCE(CVE-2026-42271,配合 Starlette 的 CVE-2026-48710,CVSS 10.0,无需登录即可远程执行命令)就是血淋淋的教训——当所有流量都过这道网关,它一旦被攻破,等于把模型凭证、数据、密钥一锅端。第二,“不可变日志 + 状态查询”在自托管下不是开箱即得,要靠 WORM / 哈希存证 + 自建留存策略补齐。
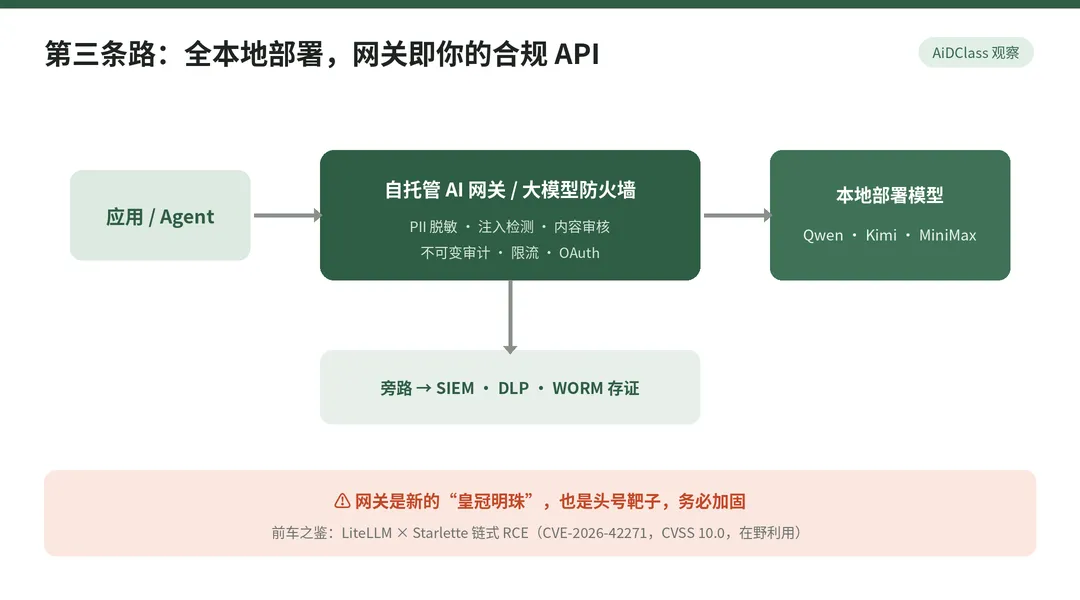
全本地部署:网关即你的合规 API
六、四种路线放在一起,三个判断
把四种形态摆到一张表上,差异一目了然:开放派(Anthropic / OpenAI)靠对外 API 引生态;整合派(Google、国内大厂)内嵌自家云的安全栈;国内中立厂商这块基本是空白;而全本地部署,则把控制点和生态主权完全交回到企业自己手里。
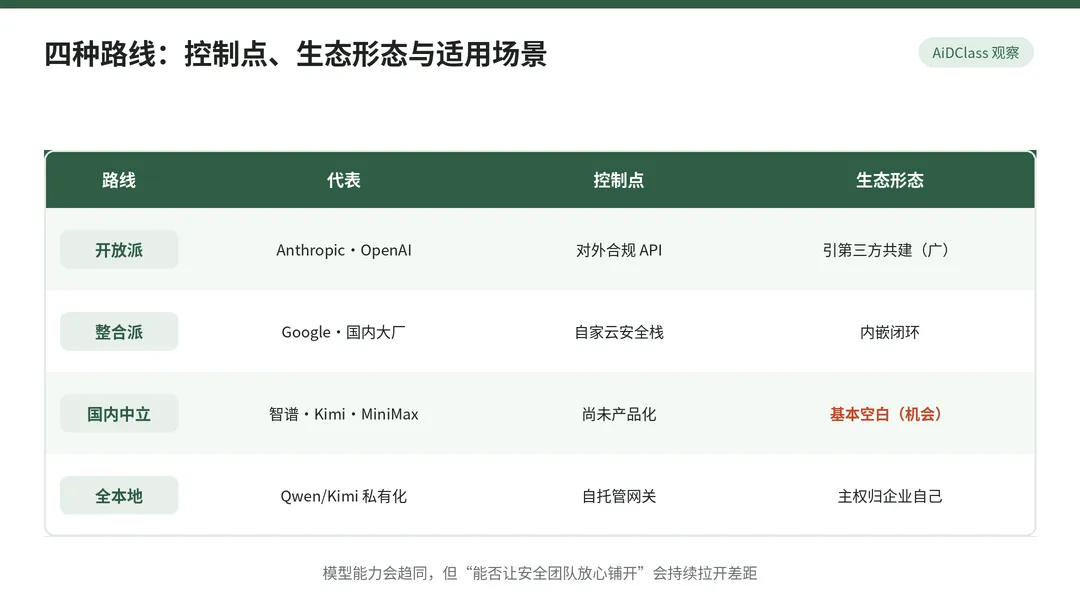
四种路线:控制点、生态形态与适用场景
由此给出三个判断:
判断一:安全生态会成为模型厂商竞争的隐形战场。 模型能力会趋同,但”能不能让企业安全团队放心地铺开”会持续拉开差距。谁的安全生态更完整,谁就更容易把 token 卖进受监管的大客户。
判断二:国内的机会在”中立厂商 + 开放合规 API”。 大厂会继续走垂直整合的闭环,而真正能让独立安全厂商一起受益、把蛋糕做大的,是中立模型厂商的开放姿态。这一步谁先迈出,谁就可能定义国内的标准。
判断三:对企业,本地网关是当下最可控的落地路径。 在数据敏感、强监管的场景下,与其等一个开放生态成熟,不如把控制点握在自己手里——前提是把那道网关本身守好。
七、写在最后:所有防线的地基,仍是数据本身
无论是云上的合规 API、巨头的整合套件,还是本地的网关防火墙,它们拦截与放行的每一次判断,最终都要回答同一个问题:这条数据是什么、几级、属于谁、能不能进这个上下文。
这个判断做不出来,上面所有的审计、DLP、守护栏,本质上都只是在赌。治理恐惧之所以挥之不去,根子也在这里——企业怕的不是”AI”,是”看不清自己的数据流向哪、被谁用了”。
这也正是 AiDClass 一直在做的那一环:给企业的每一条数据,装上自动化的分类分级与语义身份。生态可以层层叠加,路线可以各有取舍,但只有当数据先学会自己说话,那道”治理恐惧”的采购闸门,才真正拆得掉。
—— 模界数智 · AiDClass 团队
从哪里开始
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流