AI 数据安全:哪些能买到,哪些必须自建
上一篇提出了”先给数据建立语义标签,再逐层建设授权、控制与审计”的架构,收到不少关于落地的追问。这一篇基于公开资料梳理国际产品的现状,并借这些事实反过来检验上一篇的判断:哪些成立,哪些只部分成立,哪些还缺证据。
一、先回应几个被问得最多的问题
上一篇发出后,收到不少专业的追问:数据切分和打标怎么保证准确?“明细不可用、聚合可用”由谁来实现?任务授权传递到子 Agent(Sub Agent)之后是否还有效?以及最集中的一条——没有现成框架,怎么落地?
这些问题都非常专业,问到点子上了。这一篇我们从部分国际大厂和初创企业的实际产品实现来做一次分析,补充工程现状。过去两年,国际安全厂商在这个方向上已经有一批可查证的产品。需要先说明两点:本文的分析基于各厂商公开资料,实际能力需结合产品测试确认;另外,写这篇的目的不是找证据证明上一篇正确——对照产品现实,从实际的产品中,看看各家对于实际问题的解决方法和思路,从中获得更多的实践启发。
**二、和文中的思路最接近的产品:**Securiti Gencore AI
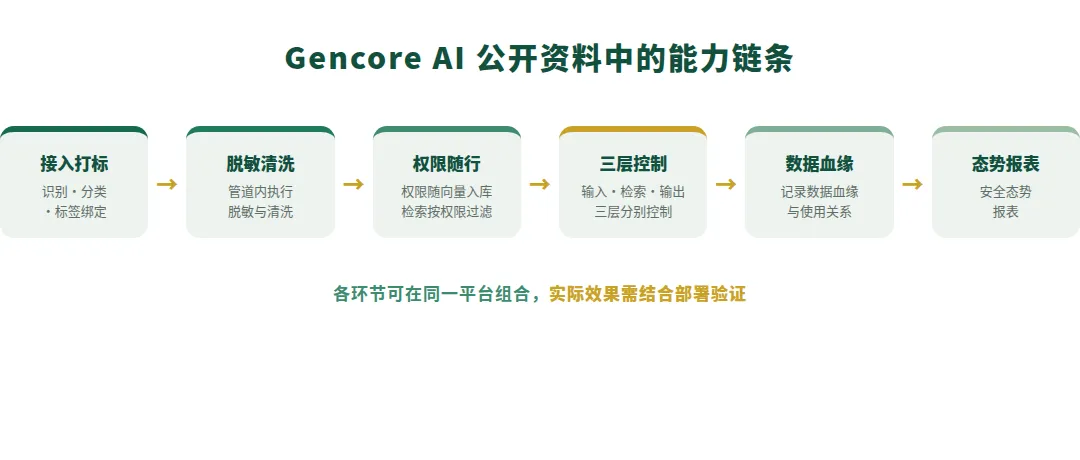
先看对照上一篇架构覆盖最完整的产品。Securiti 的底座是数据安全治理平台(DSPM 方向),2024 年在此基础上发布 Gencore AI,能力链条是:数据接入时完成识别、分类和标签绑定(含敏感级别、权属、法规映射);接入管道内执行脱敏与清洗;数据向量化时保留原始权限信息(entitlement-aware embeddings),检索阶段按用户权限和数据标签过滤召回;在输入、检索、输出三个位置分别设置控制;记录数据血缘和使用关系;提供安全态势报表。
在Gencore AI的实现中,我们还是以《华东区机构客户清单.xlsx》为例,在Gencore AI中是这样处理的:
第一步,数据进门先领身份证。客户清单接入时,系统自动识别内容、自动分类打标——什么类别、什么级别、归谁管、对应哪条法规,全写在标签里。前期处理完成后,后期在使用身份证来验证数据不需要现场进行判断和猜测。
第二步,进门时顺手把该遮的遮掉。接入管道上直接执行企业规矩:该脱敏的脱敏、该删的删、重复的去掉。对应上一篇的第一道门禁——语料入库门禁。
第三步,权限跟着数据一起进 AI 的资料库。这是最核心的一步:数据变成 AI 可检索的资料(向量)时,“谁能看这份数据”的信息跟着一起装进去。张伟的任务来检索时,系统按他的权限和数据的标签过滤——超出范围的内容,压根不会出现在候选名单里。
第四步,三道防火墙合围。它的防线明确分三个位置:输入端(拦提示词注入、去掉输入里的敏感信息)、检索端(就是第三步)、输出端(拦住往外走的敏感内容)。
第五步,全程记族谱。哪个文件、变成了哪些资料、装进了哪个库、被哪个 AI 用过——一张关系图全程记录。张伟的汇报要外发?上游有没有高敏感明细,图里查得到。
第六步,态势报表。覆盖了多少数据、拦了多少次,仪表盘上有清晰的显示。
从这一家能得出的结论是有限但实在的:数据侧先打标、检索时按权限和标签过滤,这条路线已经有完整的商业实现;再往上的部分,各家走法不一。
三、微软:在数据内容生态内做得最深的一家
如果只看单点能力的扎实程度,微软的公开文档最多,也最可验证。Purview 敏感度标签随文件流转;DLP 提供面向 Copilot 的策略位置,可以把带特定标签的内容排除在 Copilot 处理范围之外(2026 年年中起逐步推送的能力甚至允许特定标签的文件直接不被 Copilot 分析);Copilot 生成的文档会继承来源中最高等级的标签;Entra Agent ID 给 AI Agent 建立独立于人的身份,支持条件访问和工具绑定。
这几项合起来,已经非常接近上一篇说的”标签驱动 AI 行为”。它的边界也明显:整套机制在 Microsoft 365 生态内闭环,出了自家体系难以复用;标签继承在多来源、多标签场景下的具体行为,公开文档语焉不详,需要实测。
**四、**其他厂商的实现
新兴数据安全厂商Bonfy 的核心概念叫”The Who”:两份文档即使标签相同,背后的客户关系和监管义务不同,风险也不同。它的做法是用持续学习的知识图谱,在运行时动态判断数据背后的实体和义务,而不依赖预先打好的标签。
网络安全大厂Palo Alto 的 Prisma AIRS 做运行时管控——工具调用、MCP 连接、Agent 间通信、Agent 身份清点,不涉及数据侧标签,但是Palo Alto还是以网络安全管控为主。它和数据侧产品分属两个阵营,目前没有看到两边打通的集成,这本身就是落地时要面对的现实问题。
Knostic 则是补充了微软的“语焉不详”的部分,核心是基于Purview提供了一套面向企业生成式 AI 和 AI Agent 的知识安全平台,重点解决 Copilot、企业 RAG、AI 助手在调用内部文档时产生的过度披露问题。它不仅判断用户是否有权访问某个文件,还会结合用户身份、岗位、业务目的、数据敏感级别和提问上下文,判断用户是否“应该知道”AI 最终生成的答案,并通过风险扫描、模拟提问、权限修复以及运行时过滤、脱敏、摘要或阻断等方式,防止 AI 将分散在多个合法数据源中的信息汇总、推理成不应被披露的敏感结论。
其他还有不同的厂商都在围绕模型、Agent、MCP等构建安全产品,形态也各异,但总的来说,个人意见,在数据处理的前期对数据进行标签化的处理,总体的成本会比后期再进行识别防护的成本要低,同时前期方案无论从策略制定复杂度、有效性、处理性能上来说,都会优于后期方案。
五、授权模型
当大量运行的系统都是用Agent来替代真人操作终端来操作数据的时候,Agent以及Sub Agent 授权传递的问题,最复杂的点在授权模型。
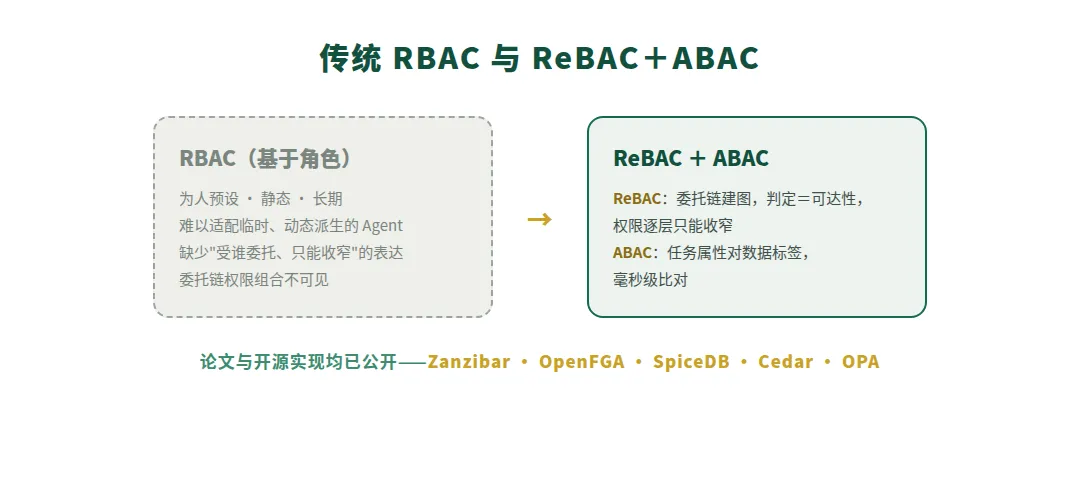
传统 RBAC 以人为单位预设角色,前提是主体长期存在、角色稳定、数量有限;但Agent 临时存在、动态派生、数量大,RBAC 也缺少”受谁委托、权限只能收窄”的表达能力。
工程上可行的替代是 ReBAC 和 ABAC。ReBAC(基于关系的授权,源自 Google Zanzibar 论文,开源实现有 OpenFGA、SpiceDB)把”人—任务—子任务—工具—数据”的委托关系建成图,授权判定即图上可达性,子 Agent 权限从父任务裁剪、逐层收窄;ABAC(基于属性的授权,策略引擎如 Cedar、OPA)用任务属性与数据标签比对。令牌层面,Biscuit、Macaroon 等格式支持”只能追加约束”,可承载逐层收窄的授权传递。这些组件有公开论文和开源实现,成熟度足够,缺的是结合具体业务的装配。ReBAC/ABAC过去没有大量投入的主要原因也是因为管理的复杂度和必要性不足,但在Agent横行的时代,ReABC/ABAC逐步变成了必需品。而复杂度也需要依靠AI来降低使用与配置的复杂性。
**六、**总结
把产品现实摆在一起,上一篇的判断可以分成三档。
得到多家独立实现支持的:数据侧预先打标、检索按权限和标签过滤(Securiti、微软两家独立实现);在输入、检索、输出等多个位置分层控制(多家产品采用类似划分);Agent 需要独立于人的身份(微软已产品化);记录数据血缘(多家支持)。
只部分成立的:三个控制位置的具体划分,各家和上一篇互有出入;血缘的用途——上一篇设想用血缘在转发、外发时做事中拦截,但公开资料里,各家的血缘能力主要用于审计和溯源,用于实时判定的证据很少。
还缺证据的:
任务级短时授权,没有任何一家实现,仍属架构设想;
累计行为监测(多次合规查询累积成风险),同样没有产品实现。这两项要么是市场还没做到,要么是工程上比设想的更难——两种可能都存在,现在没法下结论。
聚合数据的治理:明细与聚合分级供给、口径和粒度的确定,这个和业务本身融合度非常紧密。因此很难从外部产品中看到这类能力。
基于中国法律法规的分类分级体系(个人信息保护法、数据安全法、行业分级目录和中文业务语义——国际产品围绕 GDPR、HIPAA 建设,对这部分支持有限)。尤其是对于海量的非结构化数据的支持,是一大难题。
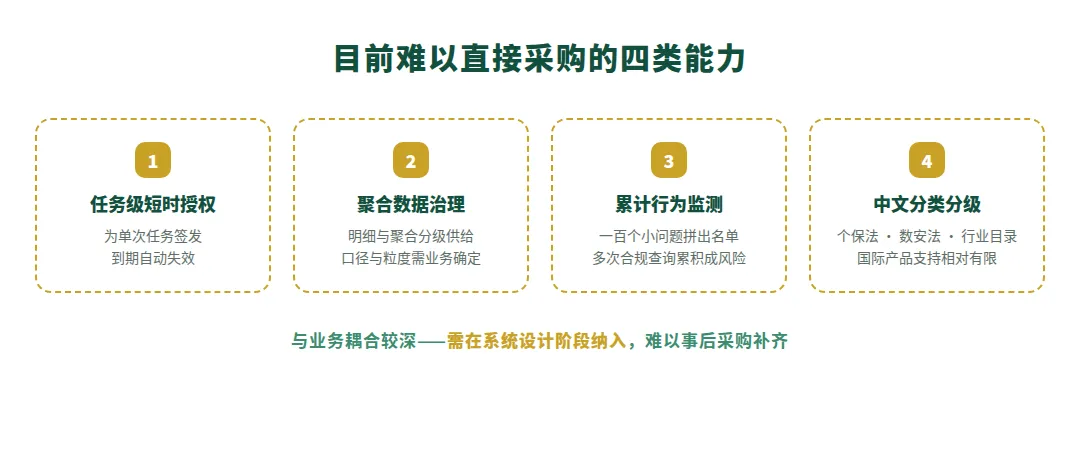
数据打标、按权限检索、分层控制、Agent 身份,这些环节可以在现有产品里找到参照,落地的工作是选型和集成;授权模型有公开论文和开源组件。任务授权、聚合治理、累计监测、目前没有现成供给,需要结合业务自建。
基于中国法律法规要求和行业特色的非结构化数据分类分级是AiDClass 核心能力,对于海量的非结构化数据处理、标签,结构化、非结构化的资产管理,资产服务目录等具有完善的体系性支持。为AI应用安全打下第一根坚实的地基桩。
欢迎继续追问,上一篇的不少修正就来自读者。
(后续按控制点逐个展开。)
参考资料
[1] Securiti,Gencore AI 与 Context-aware LLM Firewalls(产品文档)
[2] Microsoft Learn,Microsoft 365 Copilot 数据保护架构;Purview 敏感度标签与 Copilot
[3] Microsoft Security Blog,Least Privilege for AI Agents: Identity, Access, and Tool Binding(2026.7);Entra Agent ID
[4] Palo Alto Networks,Prisma AIRS(2026.3)
[5] Bonfy.AI,“The Who” Is No Longer a Metadata Problem, It’s an Enforcement Problem
[6] Knostic,The GenAI Knowledge Security Platform
[7] Google,Zanzibar: Google’s Consistent, Global Authorization System(2019);OpenFGA / SpiceDB
[8] 前篇:《你在做的安全,是面向过去的安全,还是面向未来的安全?》《面向未来的安全,从哪一根桩打起?》
说明:文中对各厂商能力的描述基于其公开资料,实际能力与覆盖范围需结合产品测试确认;产品对比仅为架构路线讨论,不构成选型建议。
—— 模界数智
正在规划企业 AI 相关项目?
建议从真实业务场景切入,优先完成项目诊断:评估业务价值、核查数据基础、识别安全与权限风险,审慎评估之后,再决定是否启动 PoC 原型建设,避免无效投入。
预约 30 分钟交流